
ECS Fargate vs Managed Instances — コストと起動速度を実測して使い分けを考える
目次
Amazon ECS の新しいコンピューティングオプション「Managed Instances」は、Fargate とどう使い分ければよいのでしょうか。この記事では同一のタスク定義を両方で動かし、起動速度、スケールアウト、ビンパッキングを東京リージョンで実測し、コストを実測構成で試算しました。CDK での構築方法や、削除時のハマりポイントも紹介します。
この記事の要約
- 起動速度はどちらも実用十分。コールドスタートの中央値は Fargate 20.2秒に対し、Managed Instances は EC2 起動込みで29.5秒だった。既存インスタンスがある場合は10.8秒と Fargate より速い
- オンデマンド同士のコスト比較では、少数タスクはもちろん、ビンパッキングが効く20タスク構成でも Managed Instances のほうが22%高かった。インスタンスを使い切った時点でちょうど同額となる価格設計である
- Managed Instances のコスト優位は Spot・RI・Savings Plans とセットで初めて生まれる。Spot 適用時は Fargate オンデマンド比で36%安くなった
- 管理料は「一律 $0.02/時」ではなく「インスタンスのオンデマンド価格の12%」(非 GPU 系の場合)。EBS 代と合わせた実効コストで判断する必要がある
- インスタンスの terminate/reboot は明示 Deny されており、ユーザーからは終了させられない。削除の順序を誤ると回収不能な手詰まりに陥るので注意
1. ECS Managed Instances とは
2025年9月末にローンチされた、ECS の新しいコンピューティングオプションです。10月には東京を含む全商用リージョンに展開されました。
EC2 インスタンス上でタスクを動かしますが、インスタンスのプロビジョニング・スケーリング・パッチ適用はすべて AWS が管理します。「Fargate の運用レス」と「EC2 の柔軟性(インスタンスタイプ選択・GPU・Spot)」の中間に位置する選択肢です。
主な特徴は次のとおりです。
- OS は Bottlerocket 固定。カスタム AMI 不可、SSH 不可(ECS Exec のみ)
- セキュリティパッチ適用のため、インスタンスは最長14日で自動入替になる
- 1インスタンスに複数タスクを詰めるビンパッキングで集約率を高める
- Auto Scaling グループやスケーリングポリシーの設定は不要。すべて自動
- タスク定義は Fargate プラットフォームバージョン 1.4.0 と互換
管理料は「一律 $0.02/時」ではない
解説記事の多くに「管理料は $0.02/時/インスタンス」とありますが、Pricing API で確認すると実際はインスタンスタイプごとの価格でした。東京リージョンで782タイプ分を取得したところ、非 GPU 系は確認した範囲でいずれもオンデマンド価格のちょうど12%です。GPU やアクセラレーテッド系は2026年7月の値下げで例外になっており、手元のデータでは G 系が約7.8%、P 系や Trainium は約4.8%相当でした。
| インスタンスタイプ | オンデマンド | 管理料/時 |
|---|---|---|
| c6a.large | $0.0963 | $0.011556 |
| m5a.large | $0.1120 | $0.013440 |
| m7i.large | $0.1302 | $0.015624 |
| t3.large | $0.1088 | $0.013056 |
| i7ie.metal-48xl | $29.366 | $3.523968 |
小型インスタンスなら $0.02 より安く、i7ie.metal-48xl のような大型では $3.52/時に達します。コスト試算の前提が変わるので注意してください。
2. 検証の構成
東京リージョンに使い捨ての環境を組みました。
| 項目 | 内容 |
|---|---|
| IaC | AWS CDK 2.1135.0(aws-cdk-lib 2.263.0、TypeScript) |
| ネットワーク | VPC + プライベートサブネット×2、NAT ゲートウェイ×1 |
| ワークロード | nginx(public.ecr.aws/nginx/nginx:stable)、0.25 vCPU / 512 MiB |
| サービス | 同一タスク定義から Fargate 用 / Managed Instances 用の2サービス |
| インスタンス条件 | 2 vCPU・4〜8 GiB・x86・非バースト(instanceRequirements で指定) |
| 計測 | DescribeTasks のサーバー側タイムスタンプ(createdAt / pullStartedAt / pullStoppedAt / startedAt) |
計測の公平性のため、次の2点を揃えています。
- 両サービスを同一のプライベートサブネットへ配置し、イメージ取得は同じ NAT ゲートウェイ経由で統一する。Managed Instances はパブリック IP 割り当てに非対応で、プライベートサブネットが必須である
- 起動のトリガーはサービスの desiredCount 変更に統一する(RunTask 直叩きとはスケジューラ遅延の乗り方が変わるため)
3. CDK での構築
3-1. タスク定義は1つでよい
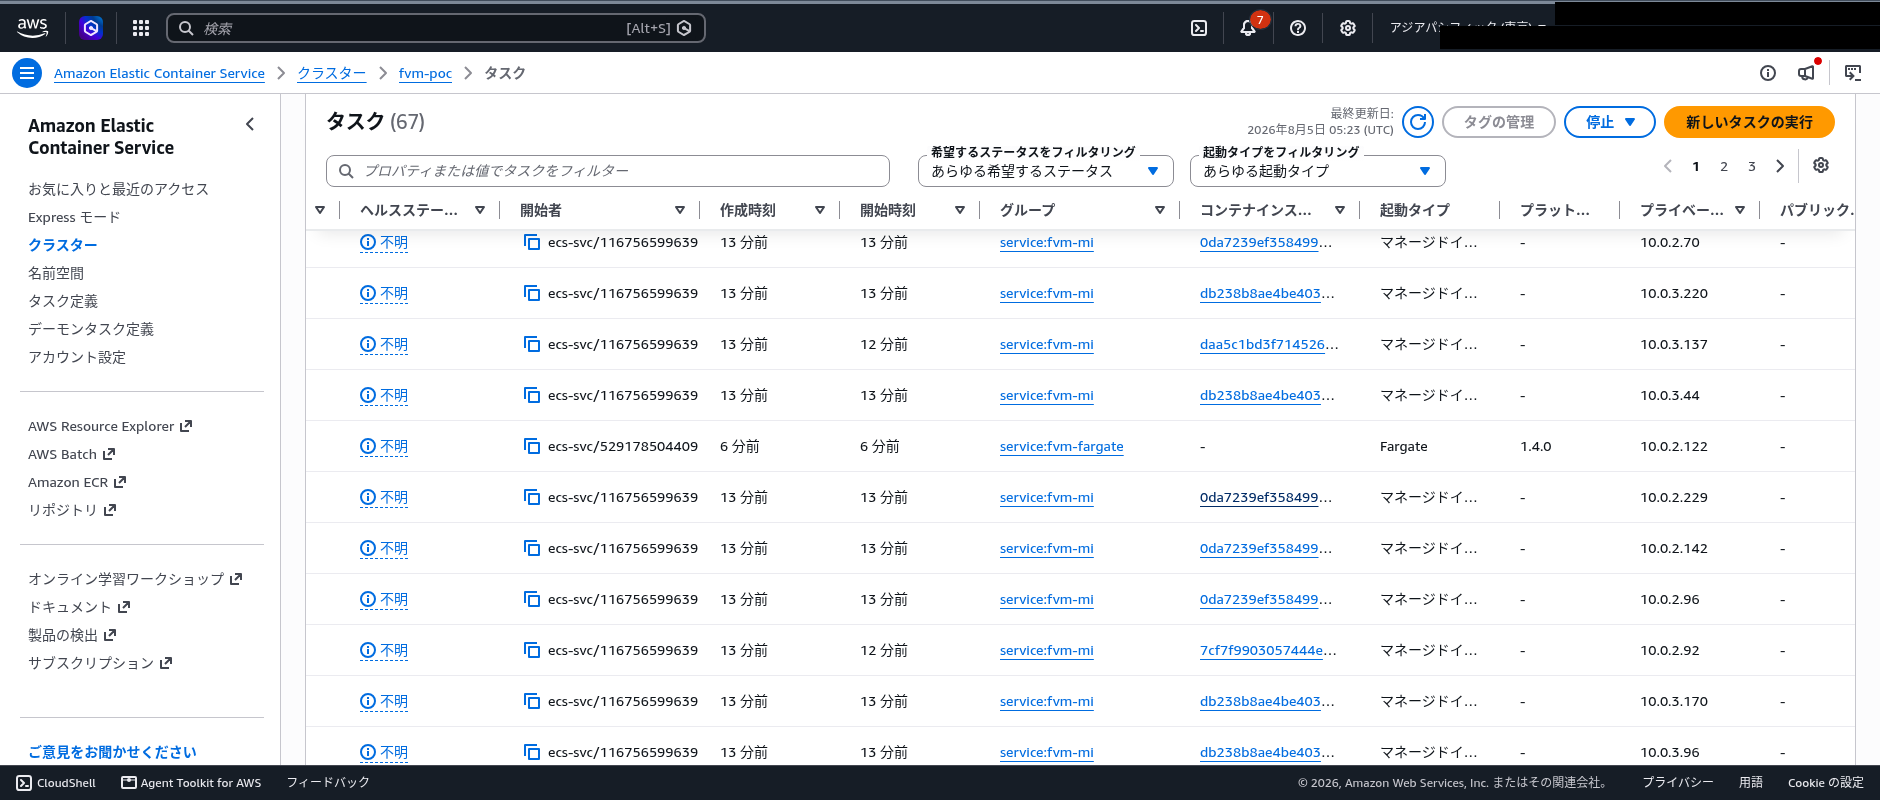
タスク定義は requiresCompatibilities に FARGATE と MANAGED_INSTANCES を併記でき、1つの定義を両方のサービスで使い回せます。実機でも、同じ fvm-poc-nginx:1 から起動した2サービスがそれぞれ launchType FARGATE / MANAGED_INSTANCES で RUNNING になりました。
const taskDefinition = new ecs.TaskDefinition(this, 'NginxTask', {
  family: 'fvm-poc-nginx',
  compatibility: ecs.Compatibility.FARGATE_AND_MANAGED_INSTANCES,
  cpu: '256',
  memoryMiB: '512',
  networkMode: ecs.NetworkMode.AWS_VPC,
});
移行の観点では、これは大きな利点です。タスク定義を作り直さずに、キャパシティプロバイダーの切り替えだけで両者を行き来できます。
3-2. サービスは FargateService で書く(現状の罠)
キャパシティプロバイダーには L2 コンストラクト ManagedInstancesCapacityProvider が用意されています。一方で Managed Instances 専用の Service / TaskDefinition の L2 は未実装です(aws-cdk#36035)。そのためサービスは FargateService を使い、capacityProviderStrategies で Managed Instances へ振り向けます。直感に反しますが、これが現状の書き方です。
const miCapacityProvider = new ecs.ManagedInstancesCapacityProvider(this, 'MiCapacityProvider', {
  capacityProviderName: 'fvm-poc-mi',
  subnets: privateSubnets,
  securityGroups: [taskSecurityGroup],
  instanceRequirements: {
    vCpuCountMin: 2,
    vCpuCountMax: 2,
    memoryMin: cdk.Size.gibibytes(4),
    memoryMax: cdk.Size.gibibytes(8),
    cpuManufacturers: [ec2.CpuManufacturer.INTEL, ec2.CpuManufacturer.AMD],
    burstablePerformance: ec2.BurstablePerformance.EXCLUDED,
  },
});
cluster.addManagedInstancesCapacityProvider(miCapacityProvider);

const miService = new ecs.FargateService(this, 'MiService', {
  cluster,
  taskDefinition,
  capacityProviderStrategies: [
    { capacityProvider: miCapacityProvider.capacityProviderName, weight: 1 },
  ],
});- instanceRequirements は属性ベースの指定で、具体的なタイプは AWS が抽選する。今回の条件では主に c6a.large が選ばれた
taskVolumeStorageプロパティで EBS データボリュームのサイズを変更できる(デフォルト 80 GiB、最小 30 GiB)
3-3. 起動したインスタンスを見て分かったこと
起動された c6a.large を DescribeContainerInstances で見ると、細かい発見が2つありました。
- 登録メモリは 3488 MiB。公称 4 GiB のうち Bottlerocket とエージェントの予約分が引かれる。512 MiB タスクは計算上、8個でなく6個までしか載らない
- EBS が2本付く。8 GiB のルート(Bottlerocket OS)と 80 GiB の gp3 データボリュームで、計 88 GiB ≒ $0.0116/時。c6a.large の管理料とほぼ同額の隠れコストになる
4. 起動速度を実測する
3パターンをそれぞれ10回計測しました。値はすべて DescribeTasks のサーバー側タイムスタンプ(createdAt → startedAt)です。
| パターン | 中央値 | 範囲 | pull 中央値 |
|---|---|---|---|
| Fargate コールド(毎回新規環境) | 20.2秒 | 16.6〜30.1秒 | 6.5秒 |
| MI ウォーム(既存インスタンスに追加) | 10.8秒 | 9.7〜16.5秒 | 2.1秒 |
| MI コールド(インスタンス新規起動込み) | 29.5秒 | 27.2〜32.5秒 | 4.5秒 |
ポイントは3つあります。
- 既存インスタンスがあれば Managed Instances は Fargate の約半分の時間で起動する。pull 2.1秒はイメージキャッシュの効果で、イメージが大きい実ワークロードほど差が開くはずである
- コールドでも +9秒程度。EC2 のプロビジョニングと Bottlerocket のブートを含めて約30秒で安定しており、ばらつきも小さい(標準偏差1.7秒)。「インスタンス起動を伴うから遅い」という予想は実測で覆った
- コールド同士で比べると、pull は MI の4.5秒に対して Fargate が6.5秒。同じ NAT 経由・キャッシュなしの条件でも MI のほうが速く、プラットフォーム側の取得実装に差があるとみられる
- タスク0の状態にするとアイドルインスタンスは78〜93秒で自動回収された。回収までの間に次のタスクが来ればウォーム起動になる
なお今回の nginx はイメージが小さいため、pull 時間の差は控えめに出ています。数百 MB〜GB のイメージならキャッシュの有無がもっと効いてくるでしょう。
5. スケールアウトとビンパッキング
5-1. desiredCount 2→20 の一斉スケールアウト
| プラットフォーム | 全20タスク RUNNING まで | 経過 |
|---|---|---|
| Fargate | 33秒 | t+26秒で8、t+33秒で20(ほぼ一斉) |
| Managed Instances | 53秒 | t+14秒で6(既存1台に詰め切り)→ 2台追加起動 → t+53秒で20 |
※ 約6.5秒間隔のポーリングによる観測値です。
Managed Instances は「既存インスタンスに詰める → 足りない分のインスタンスを起動 → 残りを配置」という2段階で進みます。それでも Fargate との差は20秒でした。
5-2. ビンパッキングは「使い切る」詰め方
20タスクは3台に収まりました。内訳が面白いところです。
| インスタンス | タスク数 | 律速要因 |
|---|---|---|
| c6a.large(2 vCPU / 登録 3488 MiB) | 6 | メモリ(6 × 512 MiB = 3072 MiB) |
| c6a.large | 6 | メモリ |
| m5a.large(2 vCPU / 登録 7474 MiB) | 8 | CPU(8 × 256 = 2048 で空き0) |
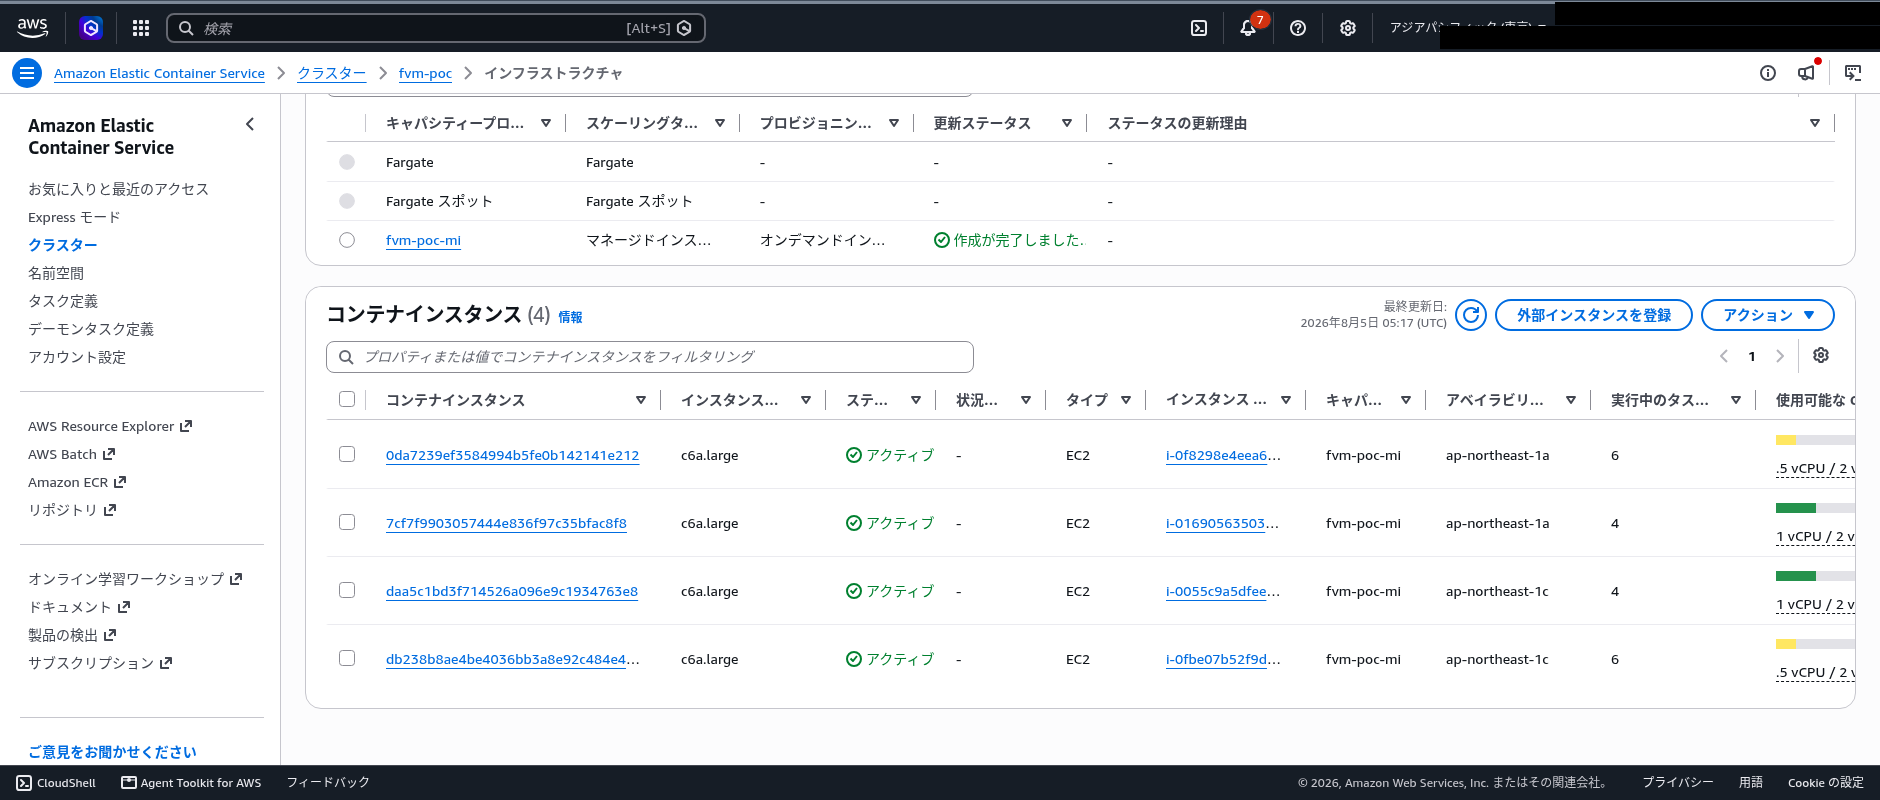
※ スクリーンショットは同条件で再現した別試行のもので、c6a.large×4台(6/4/4/6)の配置です。表の試行(3台、m5a 混在)とは構成が異なります。
- c6a.large はメモリが先に埋まり、m5a.large は CPU をぴったり使い切っている。リソースを無駄なく詰める挙動が見える
- 同じスケールアウトの中で別のインスタンスタイプが混ざる。抽選は「その時点で必要な容量」に対して行われ、タイプ固定ではない
- 配置は毎回変わりうる。同じ 2→20 を再現したら今度は c6a.large×4台(6/4/4/6)になった。「N タスクなら M 台」と固定的には見積もれない
5-3. consolidation はタスクを能動的に動かす
20→2 タスクに戻すと、インスタンスは約4.8分かけて3台→1台に統合されました。興味深いのは途中経過です。
- スケールイン直後、残った2タスクは別々のインスタンスに分散していた
- t+80秒: アイドルになった1台を回収
- t+175〜239秒: タスク数が一時的に3に増えた。生存させるインスタンスに代替タスクを先に起動してから、古いタスクを止めている(start-before-stop)
- t+287秒: 1台に完全統合。生き残ったのは安い方の c6a.large で、高い m5a.large が回収された
つまり Managed Instances は、集約率を保つためにタスクを勝手に別インスタンスへ移動します。SIGTERM を受けてから正しく終了できるよう、アプリはグレースフルシャットダウンに対応させておく必要があります。
6. コスト比較
東京リージョンの単価(2026年8月時点、Pricing API と Spot 実勢価格)で、実測構成のコストを積算しました。0.25 vCPU / 0.5 GB のタスクを 730時間/月動かす前提です。
| タスク数 | Fargate(OD) | MI(OD) | MI(Spot 実勢) |
|---|---|---|---|
| 1 | $11/月 | $87/月 | $45/月 |
| 2 | $22/月 | $87/月 | $45/月 |
| 6(c6a.large 1台が満杯) | $67/月 | $87/月 | $45/月 |
| 20(実測構成 c6a×2 + m5a×1) | $225/月 | $274/月(+22%) | $144/月(-36%) |
MI 側の内訳は「EC2 オンデマンド + 管理料12% + EBS 88 GiB」です。見てのとおり、オンデマンド同士では全ケースで Fargate が安いか同額でした。ビンパッキングが理想的に効く20タスクでも逆転しません。
6-1. 「完全パックでちょうど同額」の価格設計
理由は単価を並べると見えてきます。c6a.large の登録リソース(2 vCPU / 3488 MiB)を Fargate 単価で買うと $0.1200/時。一方 MI のバンドル(EC2 $0.0963 + 管理料 $0.0116 + EBS $0.0116)は $0.1194/時で、差はわずか0.4%です。
つまりオンデマンドの Managed Instances は「インスタンスを100%使い切ってようやく Fargate と同額」になる価格設計です。現実にはパッキングのロス(今回なら c6a.large でメモリが先に埋まり CPU の25%が遊ぶ)が必ず出るので、その分だけ Fargate より高くなります。
6-2. Spot と RI/Savings Plans で逆転する
様相が変わるのは EC2 の購入オプションを使ったときです。c6a.large の Spot 実勢($0.0385〜0.0436、AZ 最安値で計算)を当てると、バンドルは Fargate 等価の約51%になります。20タスクでは $144/月(Fargate オンデマンド比 -36%)まで下がります。RI や Compute Savings Plans も同じ方向に働きます(管理料は割引対象外です)。
Managed Instances は EC2 の柔軟性を運用レスで使う手段であって、オンデマンドのまま移行してもコストは下がりません。コスト目的で選ぶなら、Spot やコミット割引とセットで考えてください。なお中断耐性のあるワークロードなら Fargate Spot(最大70%オフ)という選択肢もあり、小粒タスクではそちらが最安になる場合があります。
※ この比較は今回の条件(x86・0.25 vCPU/0.5 GB タスク・東京・730時間/月)での実測です。Fargate の ARM 単価(約20%安)や Graviton インスタンスの利用は未検証で、タスクサイズが変わればパッキング効率も変わります。
7. 削除時のハマりポイント
検証の最後、cdk destroy で環境を消そうとして手詰まりに陥りました。事象の連鎖はこうです。
- CloudFormation が、依存関係のうえで独立している NAT ゲートウェイを先に削除した
- 20タスクのドレインが間に合わず、MI サービスの削除がタイムアウトして DELETE_FAILED になった
- NAT を失ったインスタンスの ECS エージェントが全台切断した
- エージェントが切断していると ECS はインスタンスを回収できない
- ユーザー側から
ec2:TerminateInstancesとRebootInstancesのどちらも実行できない。MI のインスタンスはリソースベースポリシーで明示 Deny されており、AdministratorAccess でも拒否される - キャパシティプロバイダーは「in use」で削除できず、EC2 4台の課金だけが続く
ECS 用の VPC エンドポイントを作ってエージェントの再接続も試しましたが、30分待っても復帰しませんでした。最終的に効いたのは次の手順です。
# 1. ゴースト化したコンテナインスタンスを強制デレジスト
aws ecs deregister-container-instance --cluster fvm-poc \
  --container-instance <arn> --force

# 2. サービスが INACTIVE になったのを確認してキャパシティプロバイダーを削除
aws ecs delete-capacity-provider --capacity-provider fvm-poc-miキャパシティプロバイダーの削除が通ると、数秒で4台とも terminated になりました。インスタンスの終了処理自体は AWS のサービスロールが EC2 API で行うため、エージェントの疎通は不要だったわけです。
教訓はシンプルです。Managed Instances の環境を消すときは、サービスの削除(タスクドレインとインスタンス回収)をすべて終えてからネットワークを消してください。具体的には desiredCount を0にし、インスタンスの回収(今回の実測では約78秒)を確認してから destroy を実行すれば、この手詰まりは起きません。
8. 結局どっちを選ぶべきか
実測結果と仕様上の制約から、判断フローを整理しました。上から順に評価してください。
| # | 条件 | 選択 | 根拠 |
|---|---|---|---|
| 1 | GPU / Trainium / Inferentia が必要 | MI 一択 | Fargate は GPU 非対応。2026年8月追加の fractional GPU も MI と EC2 のみ対応 |
| 2 | 14日を超えて動き続けるタスクがある | Fargate 一択 | MI は14日で強制入替 |
| 3 | タスクの再配置を許容できない | Fargate | MI は consolidation でタスクを移動する(実測で確認) |
| 4 | Spot / RI / Savings Plans を活用できる | MI が有利 | 実勢価格での試算で -36%〜半額 |
| 5 | 大きいイメージで頻繁にタスクが入れ替わる | MI が有利 | ウォーム起動10.8秒 + イメージキャッシュ |
| 6 | 上記に当てはまらない一般的な Web/API | Fargate | OD 同士では全ケースで安いか同額。運用も最小 |
このほか、選定前に確認しておきたい仕様上の制約をまとめます。
- MI: Linux のみ。Bottlerocket 固定でカスタム AMI は使えず、SSH も不可。パブリック IP 非対応(プライベートサブネット必須)。PlacementStrategies 非対応。デプロイ時には最大200%の容量が必要になる(キャパシティ予約が固定の環境では注意)。SCP や Allowed AMIs で AMI を制限している組織では起動できない場合がある
- Fargate: GPU 非対応。1タスクは最大 16 vCPU / 120 GB。特権コンテナと instance store は使えない
さいごに
同一タスク定義を Fargate と Managed Instances で動かし、挙動とコストを実測しました。
- 起動速度・スケール速度はどちらも実用十分。速度だけを理由に MI を選ぶ場面は少ない
- オンデマンド前提なら Fargate が基本線。MI は Spot やコミット割引を使えて初めて Fargate より安くなる
- MI は「タスクが勝手に移動する」「インスタンスに一切触れない」「削除は順序に注意」という、Fargate や EC2 と違う運用感覚が必要になる
「EC2 の柔軟性が必要だが、インスタンス管理はしたくない」という明確な理由があるときの選択肢として、Managed Instances は完成度の高い仕組みでした。その理由がないなら、Fargate を選んでおけば困りません。選定の参考になれば幸いです。
