
ECS Service Connect の Zone-Aware Routing を試す — クロス AZ 通信料はどれだけ減るか
目次
Amazon ECS Service Connect にゾーン対応ルーティング(Zone-Aware Routing)が追加されました。サービス間通信が、同一アベイラビリティゾーン(AZ)のタスクを自動的に優先するようになります。この記事では Fargate の 2-AZ 構成で実際にトラフィックを流し、VPC Flow Logs の next-hop-az-id フィールドでクロス AZ 通信の削減を計測します。あわせて、タスク数が閾値を下回ったときのフォールバック挙動と、ローリングデプロイ中のルーティングも確認しました。
この記事の要約
- Zone-Aware Routing はデフォルトで有効。設定項目自体が存在せず、新規サービスは何もしなくても効いている
- 安定状態では実測で 100% のリクエストが同一 AZ にルーティングされた(AWS 公称は「80% 以上」)
- VPC Flow Logs の
az-idとnext-hop-az-id(2026年6月追加)を使うと、クロス AZ トラフィックをワンクエリで集計できる - タスク数が「2 × AZ 数」を下回ると同一 AZ 優先は停止し、ラウンドロビンへ切り替わる。切り替えは30〜50秒で、エラーは観測されなかった
- ローリングデプロイ中はフォールバックせず、約45秒だけ部分的にクロス AZ へ流れた
- 削減額は「サービス間トラフィック(GB/月) × (1 − 1/AZ数) × $0.02」で試算できる
1. Service Connect の Zone-Aware Routing とは
2026年7月に発表された、Amazon ECS Service Connect のルーティング拡張です。
Service Connect はサイドカーの Envoy プロキシでサービス間通信を中継します。従来はリクエストが全 AZ のタスクへ均等に分散していました。AZ をまたぐ通信には送信側・受信側の双方で $0.01/GB(実効 $0.02/GB)の転送料金がかかるため、East-West トラフィックが多い構成ではこれが積み上がります。Zone-Aware Routing は、各タスクが AWS Cloud Map に登録する AZ メタデータをもとに、呼び出し元と同じ AZ のエンドポイントを優先する機能です。
ポイントは次のとおりです。
- デフォルトで有効。新しい API パラメータや設定トグルはなく、新規サービスは何もしなくても効く
- 既存サービスは1回の再デプロイで有効になる(公式ドキュメントの記載。今回は新規構築のため実機では未確認)
- 発動には閾値がある。宛先のエンドポイント数が「2 × サービスが配置されている AZ 数」未満だと無効化され、従来どおりの分散へ戻る(2-AZ なら4タスク、3-AZ なら6タスク)
- 適用対象は Service Connect を有効化したサービス。Cloud Map の DNS ベースのサービス検出だけの構成では働かない
- Fargate / EC2 の両起動タイプ・全商用リージョンで利用可能。追加料金なし
なお、似た機能に NLB のアベイラビリティーゾーン DNS アフィニティがありますが、あちらはクライアント→ロードバランサーの North-South 通信が対象です。Zone-Aware Routing が効くのはサービス→サービスの East-West 通信で、両者は補完関係にあります。また、タスク配置を AZ 間で均等に保つ AZ リバランシング(2025年9月からデフォルト有効)は、Zone-Aware Routing が効果を発揮するための土台になります。
2. 検証の構成
東京リージョンに使い捨ての 2-AZ 構成を組みました。
| 項目 | 内容 |
|---|---|
| ネットワーク | VPC + パブリックサブネット×2(ap-northeast-1a / 1c) |
| コンピューティング | Fargate。frontend(2タスク、各 AZ に1つ)と backend(4タスク、各 AZ に2つ) |
| サービス間通信 | Service Connect(Cloud Map HTTP namespace) |
| コンテナイメージ | public.ecr.aws の python:3.12-slim のみ。コードはタスク定義の command で埋め込み、ECR 不要 |
| 計測 | VPC Flow Logs(カスタムフォーマット)+ frontend のアプリログ |
2-AZ を選んだ理由は、閾値(2 × AZ 数)の検証に必要な最小タスク数が4で済み、最小コストで挙動を確認できるためです。本番でも 2-AZ 構成は珍しくなく、読者の環境で再現しやすいはずです。なお placement strategy は未指定です。それでもデフォルトの AZ スプレッドが働き、backend 4タスクは各 AZ へ2つずつ分かれました。第1章で触れた AZ リバランシングと同じく、タスクの均等配置は ECS 側が面倒を見てくれます。
frontend は 0.2 秒間隔で backend へ HTTP リクエストを送り続けます。そして自分の AZ と、応答したタスクの AZ を JSON で標準出力に記録します。backend は自身の AZ とタスク ID を返すだけの HTTP サーバーです。アプリログに双方の AZ を残すこの方式は Flow Logs(1分集約 + 約5分の配信遅延)より即時性が高く、切り替わりの瞬間を秒単位で観測できます。
3. セットアップの要点
構築は AWS CLI + シェルスクリプトで行いました。全体の手順は省略し、この検証ならではのポイントを3つ紹介します。
3-1. VPC Flow Logs は v11 フィールドで作る
クロス AZ 判定の鍵は、2026年6月に追加された next-hop-az-id フィールドです。従来の az-id は「記録対象の ENI がある AZ」しか分からず、1レコードで通信の両端の AZ を比較できませんでした。next-hop-az-id は対向の AZ を教えてくれるので、az-id != next-hop-az-id という条件だけでクロス AZ を判定できます。
FLOW_FORMAT='${version} ${interface-id} ${srcaddr} ${dstaddr} ${srcport} ${dstport} ${protocol} ${bytes} ${packets} ${start} ${end} ${action} ${flow-direction} ${az-id} ${next-hop-az-id} ${subnet-id} ${ecs-cluster-name} ${ecs-service-name} ${ecs-task-id}'
aws ec2 create-flow-logs \
  --resource-type VPC --resource-ids "$VPC_ID" \
  --traffic-type ALL \
  --log-destination-type cloud-watch-logs \
  --log-group-name "$LOG_GROUP_FLOW" \
  --deliver-logs-permission-arn "$FLOW_ROLE_ARN" \
  --max-aggregation-interval 60 \
--log-format "$FLOW_FORMAT"- ECS 固有フィールド(
ecs-cluster-nameなど、2024年5月追加)も入れておくと、後のクエリでサービス単位のフィルタが楽になる - 集約間隔は最短の60秒を指定
3-2. backend は自分の AZ を返す(HTTP/1.1 を明示する)
backend のコードはタスク定義の command に埋め込んだ Python スクリプトです。AZ は ECS タスクメタデータエンドポイントから取得します。
import http.server, json, os, urllib.request
meta = json.load(urllib.request.urlopen(os.environ["ECS_CONTAINER_METADATA_URI_V4"] + "/task"))
AZ = meta.get("AvailabilityZone", "unknown")
TASK = meta["TaskARN"].split("/")[-1]
class H(http.server.BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    def do_GET(self):
        body = json.dumps({"az": AZ, "task": TASK}).encode()
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)
http.server.ThreadingHTTPServer(("0.0.0.0", 8080), H).serve_forever()
protocol_version = "HTTP/1.1"の明示が重要。http.serverのデフォルトは HTTP/1.0 で、Service Connect の Envoy プロキシと keep-alive の挙動が噛み合わない恐れあり- タスク定義の
portMappingsにはnameとappProtocol: "http"を指定する(Service Connect の必須要件)
3-3. Service Connect の設定に Zone-Aware の項目はない
backend サービス作成時の Service Connect 設定は従来と同じです。
{
  "enabled": true,
  "services": [{
    "portName": "http",
    "discoveryName": "backend",
    "clientAliases": [{"port": 8080, "dnsName": "backend"}]
  }]
}
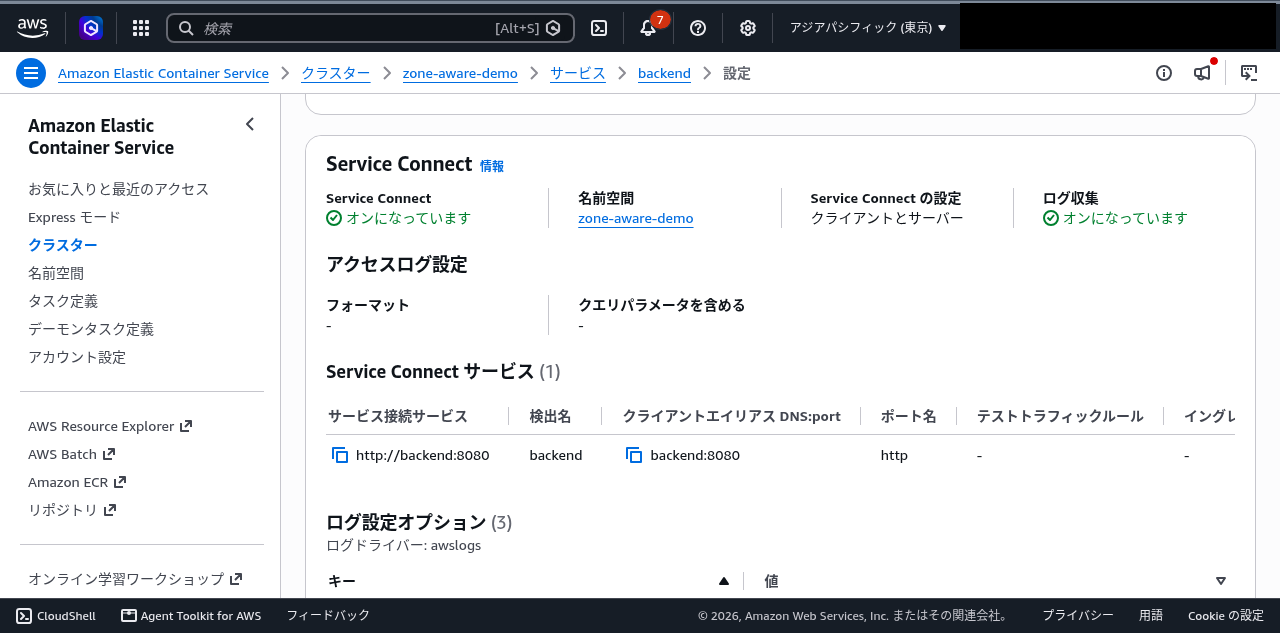
デプロイ後にコンソールで設定画面を見ても、Zone-Aware Routing の項目は見当たりません。オンにするスイッチが存在せず、気づいたら効いているタイプの機能です。
4. 結果: 安定状態では100%同一 AZ
frontend のアプリログを集計した、クライアント AZ × バックエンド AZ のマトリクスです(サービス起動からの約9分間・3,571リクエスト)。
| client AZ | backend AZ | 件数 | 平均応答時間 |
|---|---|---|---|
| 1a | 1a | 1,686 | 3.46ms |
| 1a | 1c(クロス) | 113 | 4.88ms |
| 1c | 1a(クロス) | 36 | 5.05ms |
| 1c | 1c | 1,736 | 3.40ms |
クロス AZ が149件ありますが、時系列で見るとすべてサービス起動直後の約1分間に集中しており、以降は0件でした。つまり安定状態では 100% が同一 AZ です。AWS 公称の「80% 以上」は控えめな数字で、エンドポイントが AZ 間で均等に配置されていれば、きれいに寄り切ります。各 frontend は、自分と同じ AZ にある backend 2タスクの間でだけラウンドロビンしていました。
起動直後の1分間は、エンドポイントの登録が揃うまでの過渡状態です。クロスの内訳が 1a→1c 113件・1c→1a 36件と非対称なことから、登録順による偏りが出ていたと考えられます。
応答時間は同一 AZ 約3.4ms、クロス AZ 約4.9〜5.0ms と3割ほどの差が出ました。ただしクロス AZ のサンプルは起動直後の149件だけで、コンテナのウォームアップと重なっている可能性があります。参考値としてご覧ください。
5. VPC Flow Logs でクロス AZ 通信を計測する
次に、同じ事象を VPC Flow Logs のバイト数で確認します。CloudWatch Logs Insights で次のクエリを実行しました。
parse @message "* * * * * * * * * * * * * * * * * * *"
  as version, eni, srcaddr, dstaddr, srcport, dstport, protocol, bytes, packets,
     t_start, t_end, action, direction, az_id, next_hop_az, subnet,
     ecs_cluster, ecs_service, ecs_task
| filter (dstport = "8080" or srcport = "8080") and ecs_service = "backend"
| stats sum(bytes) as total_bytes, count(*) as flows by az_id, next_hop_az
| sort total_bytes desc- カスタムフォーマットの Flow Logs は Logs Insights が自動でフィールド分解しないため、
parse @messageで分解する。ここが最初に躓きやすいポイント - Envoy が TCP 接続を終端するため、クライアント側ポートはエフェメラルポートになる。
dstport = "8080"でリクエスト方向、srcport = "8080"で応答方向のフローを捕捉する - frontend と backend の両方の ENI が同じフローを記録するので、
ecs_service = "backend"で backend ENI 視点に絞って二重計上を避ける
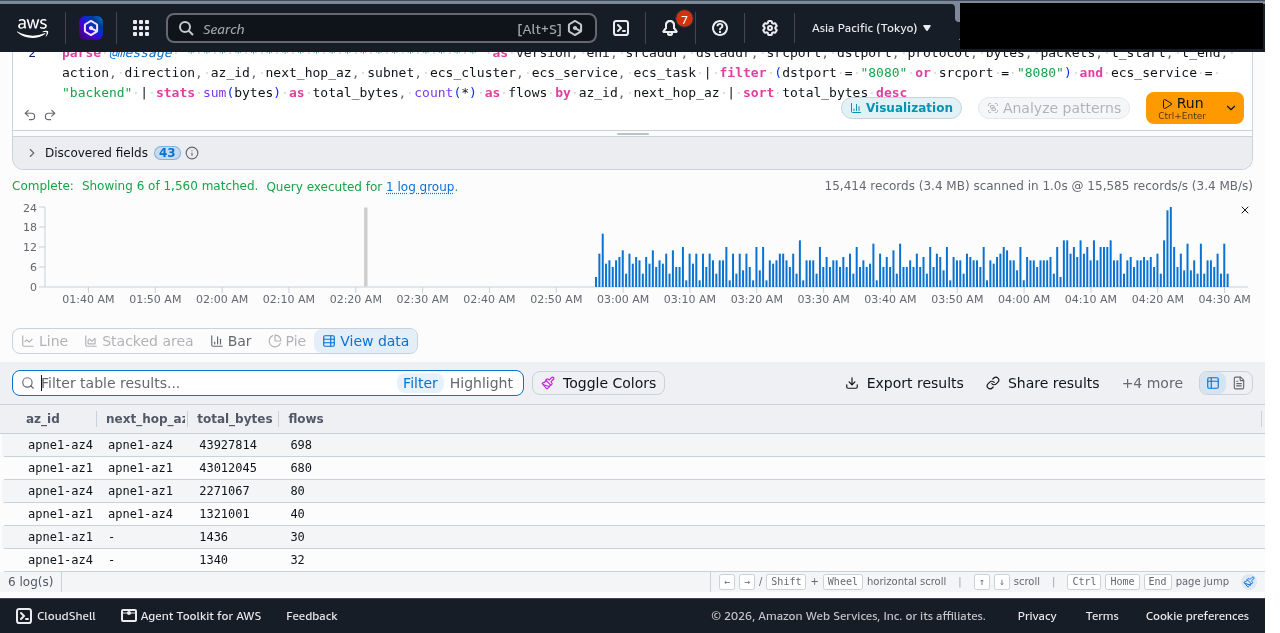
スクリーンショットは後述する閾値フォールバック実験も含む3時間窓で撮影したため、クロス AZ のバイト数が下表より多めに写っています。また az_id に入るのは AZ 名ではなく AZ ID です(本環境では 1a=apne1-az4、1c=apne1-az1)。対応は aws ec2 describe-availability-zones で確認できます。
Zone-Aware Routing が効いている状態(クエリ窓60分、実トラフィック約24分)の集計はこうなりました。
| 区分 | バイト数 | 割合 |
|---|---|---|
| 同一 AZ(az_id = next_hop_az) | 21,686,091 bytes | 98.9% |
| クロス AZ | 245,448 bytes | 1.1% |
クロス AZ の1.1%は前述の起動直後1分間の分で、安定後は0でした。なお next_hop が - の短小レコード(数百バイト、SYN のみのフローと推定)も少量混ざります。集計上は無視できる量です。
6. タスク数が閾値を下回るとどうなるか
Zone-Aware Routing には「エンドポイント数が 2 × AZ 数 以上」という発動条件があります。2-AZ 構成では4タスクです。backend を 4→3 タスクへスケールインして、この境界の挙動を観測しました。15秒ごとの同一 AZ 率の推移です。
| 時刻(UTC) | リクエスト数 | 同一 AZ | 同一 AZ 率 |
|---|---|---|---|
| 04:05:30 | 148 | 148 | 100% |
| 04:05:45 | 148 | 148 | 100% |
| 04:06:00 | 146 | 76 | 52% |
| 04:06:15 | 147 | 73 | 50% |
| 04:06:30 | 147 | 74 | 50% |
スケールイン指示(04:05:34)から約30秒で、同一 AZ 率が 100% から 50% に切り替わりました。中間状態のない、0か100かの切り替えです。3タスク時の分散を見ると、両方の frontend が3つの backend 全部へ約200件ずつ均等に投げており、同一 AZ 優先は働いていませんでした。
4タスクへ戻すと、こちらも指示から約50秒で 100% に復帰しました。どちらの切り替えでもリクエストエラーは0件です。
運用面で2つ、面白い観察がありました。
- ラウンドロビン時の同一 AZ 率は AZ 間で非対称になる。3タスクが 1a×2 + 1c×1 だったため、frontend-1a は 66.5%、frontend-1c は 33.2% だった。クロス AZ 課金は AZ 間で均等とは限らない
- スケールインでタスク数が閾値を割ると、コスト特性は静かに変わる。オートスケーリングの最小タスク数を「2 × AZ 数」以上にしておくと、この切り替わりを避けられる
7. ローリングデプロイ中はどうなるか
デプロイのたびラウンドロビンへ戻るのではと心配になりますが、結論としてはフォールバックしませんでした。backend のタスク定義を更新し、デフォルトのデプロイ設定(maximumPercent 200% / minimumHealthyPercent 100%)でローリングデプロイした際の推移です。
| 時刻(UTC) | リクエスト数 | 同一 AZ | 同一 AZ 率 |
|---|---|---|---|
| 04:21:00 | 146 | 146 | 100% |
| 04:21:15 | 148 | 133 | 90% |
| 04:21:30 | 148 | 119 | 80% |
| 04:21:45 | 147 | 140 | 95% |
| 04:22:00 | 148 | 148 | 100% |
デプロイ中はエンドポイント数が 4→最大8→4 と推移し、閾値を下回らないため、ラウンドロビンには落ちません。同一 AZ 率が下がったのは約45秒間だけで、観測窓(約5分)の約2,900リクエスト中クロスは51件(1.8%)でした。
この一時的なクロスは、新旧タスクの入れ替わりで AZ 間のエンドポイント数が瞬間的に偏った結果です。偏った分だけが他 AZ へ比例配分されました。故障やフォールバックではなく、Zone-Aware Routing が設計どおりに動いた形です。デプロイ中もエラーは0件でした。
8. コスト削減の試算
検証結果をコストの言葉に翻訳します。クロス AZ データ転送は送信側と受信側の双方で $0.01/GB が課金されるため、実効 $0.02/GB です。
閾値未達時のラウンドロビン(=従来の Service Connect の分散と同じ挙動)では、クロス AZ 率は実測でちょうど 50% でした。これは理論値(2-AZ 均等配置なら 1 − 1/2 = 50%)どおりです。Zone-Aware Routing 有効時は安定状態で 0% なので、削減額は次の式で見積もれます。
削減額/月 ≒ サービス間トラフィック量(GB/月) × (1 − 1/AZ数) × $0.02| 前提 | クロス AZ 率の変化 | 削減額/月 |
|---|---|---|
| 2-AZ、サービス間通信 1TB/月 | 50% → 0% | 約 $10 |
| 3-AZ、サービス間通信 1TB/月 | 67% → 0% | 約 $13 |
| 3-AZ、サービス間通信 10TB/月 | 67% → 0% | 約 $134 |
表の 3-AZ 行は理論値(1 − 1/3 ≒ 67%)を用いた試算です。1サービスあたりの金額は地味に見えます。しかしマイクロサービスを数十本並べる環境では、サービス間通信の総量が効いてきます。Datadog の調査(2024年)では、クロス AZ トラフィックがデータ転送コストの約半分を占めるとされています。追加料金なし・設定変更なしでこれが縮むのは、素直にうれしい変化です。あわせて同一 AZ 通信はレイテンシが低く、性能面の副次効果も期待できます。
さいごに
ECS Service Connect の Zone-Aware Routing を 2-AZ の Fargate 構成で検証しました。
- 設定不要で、安定状態では実測 100% が同一 AZ にルーティングされた
- VPC Flow Logs の
next-hop-az-id(v11)を使えば、クロス AZ 通信の計測はワンクエリで済む。自環境の「before」を測る手段としても有用 - 閾値(2 × AZ 数)を境に挙動が0か100かで切り替わる点は要注意。オートスケーリングの最小タスク数を閾値以上にしておくと安全
- ローリングデプロイでは崩れない
有効化という手順すらない機能なので、Service Connect を使っているなら、まず自環境のクロス AZ トラフィックを Flow Logs で測ってみるのがおすすめです。検証は 2026/8/3 時点の東京リージョンで実施しました。
