
セキュリティの柱を改めて読み解いてみる – Part 8: データ分類編(SEC 7)
目次
本記事では、AWS Well-Architected Framework セキュリティの柱の 7 つ目の領域「SEC 7: データの分類」を読み解きます。分類スキームの設計から、Amazon Macie による機密データの自動検出、オブジェクトタグと IAM ポリシーによるアクセス統制までを整理します。実機では、マイナンバーや日本の電話番号を含むダミーデータを Macie でスキャンしました。マネージドデータ識別子(managed data identifiers)が日本のデータをどこまで検出できるか、カスタムデータ識別子でどこまで補えるかの実測記録です。
本記事は「セキュリティの柱を改めて読み解いてみる」シリーズの Part 8 です。対象読者は AWS を実務で利用している中級エンジニアを想定しています。最終更新は 2026 年 8 月です。
シリーズ「セキュリティの柱を改めて読み解いてみる」
- Part 1: 全体像編
- Part 2: アカウント設計とルート保護編(SEC 1)
- Part 3: 認証編(SEC 2)
- Part 4: 認可編(SEC 3)
- Part 5: 検出編(SEC 4)
- Part 6: ネットワーク保護編(SEC 5)
- Part 7: コンピューティングの保護編(SEC 6)
- Part 8: データ分類編(SEC 7)(本記事)
はじめに
こんにちは、クラウドビルダーズのよこたです。
前回の Part 7(コンピューティングの保護編)では、EC2 やコンテナといったコンピューティングリソースそのものを守る話を実測しました。その結びで、次はその上で扱われるデータを分類、保管、転送の観点から守る話だと予告しています。Well-Architected ではこの 3 つが SEC 7 から SEC 9 の別々の領域になっているので、シリーズでも 3 回に分けます。今回はその入り口、SEC 7「データの分類」です。
「うちの S3 に個人情報は入っていないよね」と聞かれて、即答できるでしょうか。バケットは年々増え、中身を知る担当者は異動し、「たぶん大丈夫」という答えだけが残っている。この状況の受け皿として、よく名前の挙がるサービスが Amazon Macie です。S3 の中身をスキャンして、個人情報や認証情報を自動で見つけてくれます。これを入れれば一件落着に思えます。
実際に試しました。マイナンバー 10 件を含む CSV を S3 に置き、Macie の識別子を全部有効にしてスキャンした結果は、検出ゼロです。バグや設定ミスではなく、仕様どおりの動作でした。今回はこの検出ゼロの意味から出発して、SEC 7 の 4 つのベストプラクティスがなぜ「ツールの導入」ではなく「分類スキームの設計」から始まるのかを、実測込みで整理します。
SEC 7 の全体像と着手順
SEC 7 の問いは「データをどのように分類していますか(How do you classify your data)」です。データ分類とは、重要度と機密性にもとづいてデータを区分けし、それぞれに見合った保護と保持の統制を決められるようにする活動を指します。ベストプラクティスは 4 個です。
| BP | ベストプラクティス | 公式リスク |
|---|---|---|
| SEC07-BP01 | データ分類スキームを理解する | 🔴 High |
| SEC07-BP02 | データの機密性に基づいて保護統制を適用する | 🔴 High |
| SEC07-BP03 | 識別と分類を自動化する | 🟡 Medium |
| SEC07-BP04 | スケーラブルなデータライフサイクル管理を定義する | 🔴 High |
私が引っかかったのは、自動化の BP03 だけが Medium に置かれていることです。検出ツールの導入はいちばん目に見える対策なのに、公式のリスク評価では、スキームの理解(BP01)、統制の適用(BP02)、ライフサイクル(BP04)のほうが上にあります。
公式は、この BP 番号の順序に依存関係を持たせています。BP03 の実装手順は、最初のステップに「SEC07-BP01 で記述した組織の分類スキームをレビューする」を置いています。スキャンで見つけたリソースには「SEC07-BP02 で定義したアクセス統制を確立する」と続きます。つまり自動化は、スキームと統制が先にあって初めて機能する道具です。何を機密とみなすかの基準がないままスキャンしても、出てきた検出結果を判断できません。
分類スキームを決める(BP01)
BP01 が求めるのは、ワークロードの扱うデータの分類と取り扱い要件、保存場所、データ所有者を理解して文書化することです。公式の望ましい状態には、統制の扱うべき観点が具体的に列挙されています。
- 誰が何の目的でアクセスできるか
- どこに保存するか
- 暗号化と鍵の管理
- 保持期間と破棄のプロセス
- バックアップと復旧
- アクセスの監査
とはいえ、分類ポリシーが何もない状態から「文書化せよ」と言われても手が動きません。公式が BP02 で例示するレベル分けは public、internal、confidential、restricted の 4 段階です。これを出発点に、たたき台の表を作ってみました。
| レベル | 判断基準(漏えい時の影響) | データ例 |
|---|---|---|
| public | なし(公開が前提) | 公開 Web コンテンツ、プレスリリース |
| internal | 軽微。社外秘だが個人や取引先を特定しない | 社内手順書、集計済みの統計 |
| confidential | 重大。契約違反や補償が発生しうる | 顧客の氏名と連絡先、API キー |
| restricted | 甚大。法令で扱いが指定され、行政対応まであり得る | マイナンバー、クレジットカード番号、医療情報 |
判断基準を「漏えい時の影響」で書いているのは、新しい種類のデータが来たときに表へ追記せず判定できるようにするためです。データの種類の列挙で定義すると、列挙にないデータが全部グレーゾーンになります。
もうひとつ、この表を作る時点で決めておきたいのが、どのレベルにも当てはまらない「未分類」の扱いです。安全側に倒すなら「未分類は confidential 扱い」を既定にします。後回しにしがちな決め事ですが、後半の実測で、未分類の扱いが決まっていないと何が起きるかを実際に確かめます。
分類を実装に落とす道具として、公式はデータカタログとリソースタグを挙げています。S3 オブジェクトに classification タグを付けていく構成です。ここでひとつ注意があり、バケットなどのリソースタグには AWS Organizations のタグポリシーでキーと値の表記を強制できますが、オブジェクトタグはタグポリシーの対象外です。オブジェクトタグの値の統制は、IAM ポリシーの条件(s3:RequestObjectTagKeys など)やアップロード処理の側で行います。これに AWS Config による暗号化設定などの逸脱監視を組み合わせます。タグのキーや値に機密情報そのものを入れないこと、という注意も公式に明記されています。
分類レベルに統制を対応づける(BP02)
BP02 は、BP01 で決めたレベルごとに見合った保護統制を適用することを求めています。全データへ同じ統制を適用するのは、公式がアンチパターンの筆頭に挙げる形です。機密度の低いデータに過剰な統制を掛ければコストと利便性を失い、高いデータに足りなければ保護になりません。
BP01 の観点のうち主要な 6 つを行に、4 レベルを列にすると、統制対応表になります。セルの中身は組織の要件で変わる、埋め方の一例です。
| 統制観点 | public | internal | confidential | restricted |
|---|---|---|---|---|
| アクセス制御 | 読み取りは公開、変更は制限 | 社内ロールのみ | 業務ロール限定 + タグ条件 | 専用ロール限定 + タグ条件 |
| 分離境界 | 共用アカウント | 共用アカウント | ワークロード別アカウント | 専用アカウント + SCP |
| 暗号化 | 既定の SSE-S3 | 既定の SSE-S3 | KMS カスタマーマネージドキー | KMS + キーポリシー分離 |
| 保持と破棄 | 任意 | 自動失効 | 保持期間を定義し自動削除 | 法定保持 + 破棄の証跡 |
| 監査 | 不要 | アクセスログ保存 | ログ + 定期レビュー | ログ + アラート + 逸脱検知 |
| 自動検出 | 対象外 | 対象外 | Macie 定期ジョブ | Macie 定期ジョブ + カスタム識別子 |
レベルが上がるほど、統制の重心は権限の限定から環境の分離へ移ります。分離境界について公式は具体的で、機密度レベルごとに AWS アカウントを分け、SCP でレベルに応じたサービスとアクションを制限する構成を推奨しています。トークン化や匿名化でデータ自体の機密度を下げる選択肢も統制の一部です。
この表のうち、暗号化と鍵管理の中身は次回の Part 9(SEC 8)で扱います。
Macie は日本のデータをどこまで見るか(BP03 前半)
Amazon Macie は S3 上の機密データを検出するサービスです。検出の物差しはマネージドデータ識別子と呼ばれる、Macie 組み込みのパターン集です。クレジットカード番号、各国の個人識別番号、AWS のシークレットキーなどが定義されています。検出の動かし方は 2 つあります。
- automated discovery(機密データ自動検出):バケット群からオブジェクトをサンプリングして、継続的に調べる
- sensitive data discovery ジョブ(機密データ検出ジョブ):対象を指定して、原則すべてのオブジェクトを調べる(サンプリング深度の指定もできる)
公式の使い分けは、automated discovery で当たりを付けてから、ジョブで対象を絞って詳しく調べる順です。今回は結果の再現性を優先して、1 回限りのジョブを使いました。
検証の構成
用意したのはダミーデータ 9 ファイル、各 10 行です。実在の個人から取得した情報は使わず、すべて乱数から機械生成しました。マイナンバーは 12 桁の形式ダミー、クレジットカード番号は Luhn チェックを通る形式にしてあります。
| 区分 | 内容 |
|---|---|
| 日本のデータ 5 種 | マイナンバー、電話番号、パスポート番号、運転免許証の番号、日本語の氏名と住所 |
| 英語圏の比較用 2 種 | 米国 SSN、クレジットカード番号 |
| 負例 2 種 | マイナンバーと同じ 12 桁の注文番号、キーワードなしの数値列 |
データ型ごとにファイルを分けたのは、複数の型を 1 オブジェクトに入れると検出結果の severity(重要度)が最も高い型に引っ張られ、型ごとの severity を比べられなくなるからです。
ジョブの設定にはひとつ落とし穴があります。ジョブ作成時に既定で選ばれる推奨識別子セットには、氏名、住所、各国の電話番号が含まれていません。検出ノイズを減らすための構成ですが、このまま実行すると「識別子が対象外だから検出されない」のか「識別子を使っていないから検出されない」のかを区別できません。今回は全 166 識別子を明示的に有効化し、サンプリング深度も 100% に固定しました。
結果
| ファイル | 結果 |
|---|---|
| 米国 SSN | 10 行すべて検出。severity High |
| クレジットカード番号 | 10 行すべて検出。severity High |
| マイナンバー | 検出結果なし |
| 日本の電話番号 | 検出結果なし |
| パスポート番号 | 検出結果なし |
| 運転免許証の番号 | 検出結果なし |
| 日本語の氏名と住所 | 検出結果なし |
| 負例 2 種 | 検出結果なし |
英語圏の 2 ファイルは全行が検出され、同じジョブで日本の 5 ファイルには検出結果が 1 件も作成されませんでした。陽性が 2 件出ている以上、ジョブが動いていなかった線は消えます。ただし検出のロジックは識別子ごとに違うため、この対照は完全な証明ではなく、あくまで「検出結果が作成されなかった」という観測です。
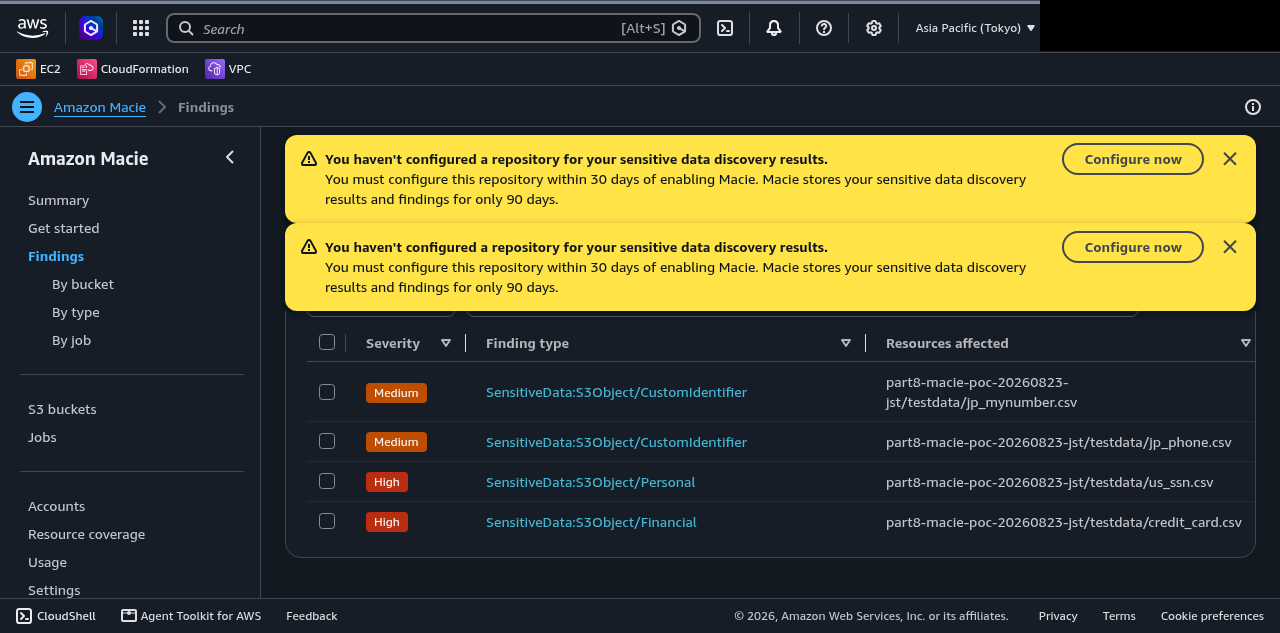
なお、画像に写っている Medium の 2 件は、このあと作るカスタムデータ識別子によるものです。マネージドデータ識別子だけのジョブでは、High の 2 件しか出ません。
検出ゼロの正体
理由は Macie の識別子一覧にあります。list-managed-data-identifiers で全 166 件を取得して確認すると、ID に JAPAN を含むものは 0 件でした。電話番号に 7 種、パスポートに 7 種、運転免許証には 32 種もの国別識別子が並ぶのに、どれも欧米が中心で、日本はどこにも入っていません。マイナンバーに至っては、国民識別番号のカテゴリに日本の項目そのものがありません。
氏名と住所には、国を冠しない汎用の識別子が一覧に存在します。ただし ID の名前だけでは分からない限定があります。公式リファレンスを引くと、氏名は「ラテン文字セットに限る(Support is limited to Latin character sets.)」、住所も対象国に日本が含まれないと明記されています。確認は 2 段構えです。一覧で識別子の有無を確かめ、リファレンスで対象範囲を確かめます。
検出ゼロは「機密データがない」ことを意味しません。「検出器がそのデータを対象にしていない」だけの場合があります。検出ツールの結果を読むときは、そのツールが何を検出できるのかを先に確かめる必要があります。冒頭の検出ゼロも、この確認を先にしていれば、実測の前に予測できた結果でした。
一方で、国に依存しない識別子は日本のワークロードでも有効です。今回の実測でも、クレジットカード番号は全行が検出されています。公式の一覧には AWS のアクセスキーや秘密鍵といった認証情報の識別子も含まれます。「日本では Macie が役に立たない」という話ではなく、効く範囲と効かない範囲の境界が、識別子の一覧という形で公開されているだけです。
検出結果の保持期間
検出結果(findings)も、discovery results(オブジェクトごとの分析結果の記録)も、Macie 内での保持は 90 日です。discovery results を長期保存するには、カスタマーマネージドの KMS キーで暗号化した S3 バケットをリポジトリとして設定します。findings 側の長期保持は、EventBridge 経由で外部へ送る構成が公式の案内です。リポジトリが未設定のままだと、コンソールに警告が出続けます。
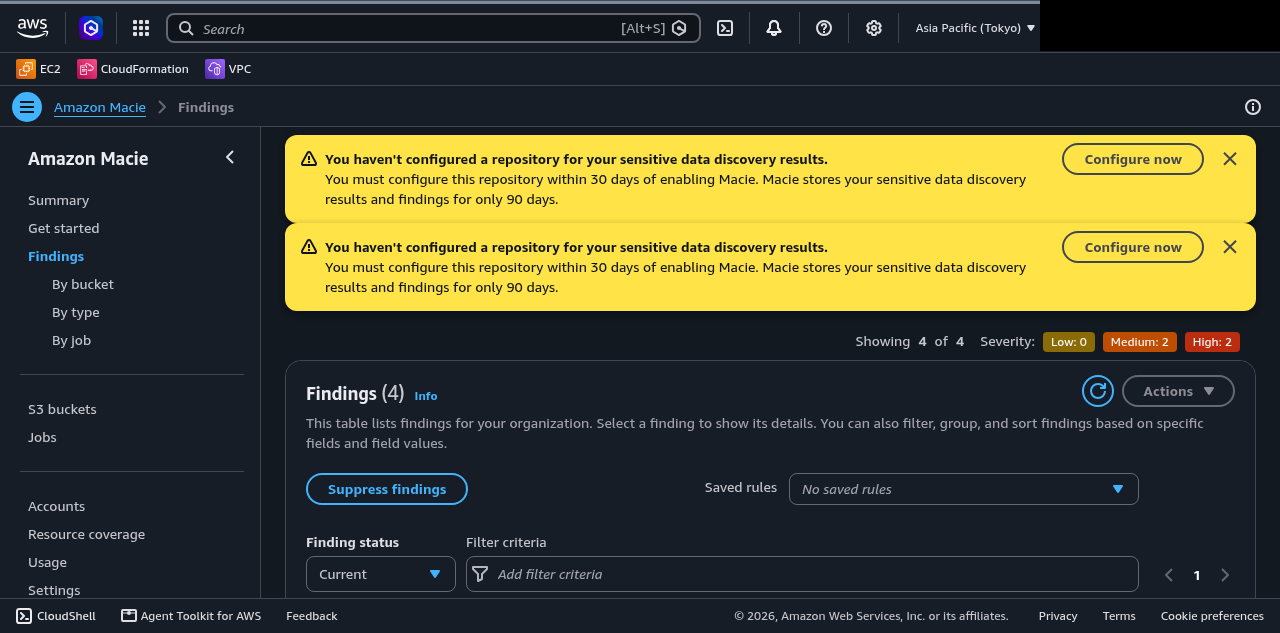
このリポジトリには、ジョブが分析したオブジェクトごとの記録が、検出の有無や分析の失敗まで含めて書き出されます。つまり未設定だと、非検出のオブジェクトについて「分析は成功していた」と後から示す手段がありません。今回の検証もリポジトリ未設定で実施したため、非検出側の証拠は「検出結果が作成されなかった」という観測と、同じジョブで陽性が 2 件出ていたという間接証拠に留まります。監査要件があるなら、リポジトリは Macie の有効化とセットで設定する項目です。
カスタムデータ識別子で補う(BP03 後半)
マネージドデータ識別子が日本のデータを見ないなら、自分で定義することになります。カスタムデータ識別子は、正規表現と、その近くにあるべきキーワードの組で独自の検出パターンを定義する仕組みです。
マイナンバー用として、12 桁の数字にマッチする \b\d{12}\b を正規表現に、「マイナンバー」と「個人番号」をキーワードに指定しました。maximum match distance(最大一致距離。キーワードの末尾からマッチした文字列の末尾までの許容文字数)は、既定の 50 文字のままです。日本語のキーワードも問題なく受理されます。同じ要領で、日本の電話番号用に 0\d{1,3}-\d{4}-\d{4} とキーワード「電話番号」の識別子も作りました(ハイフン区切りの表記だけを対象にしています)。
カスタムデータ識別子は作成後に変更できません。検出結果の履歴の不変性を保つためだと公式が説明しています。正規表現を間違えたら、識別子を作り直してジョブも再実行です。だからこそ AWS は、test-custom-data-identifier API(コンソールでは Evaluate ボックス)による作成前のテストを強く推奨しています。
test API とジョブの食い違い
その test API に、実際の CSV 全文(ヘッダー 1 行とデータ 10 行)を渡すと、マッチ数は 2 でした。マイナンバーは 10 個あるのに、です。原因は距離です。キーワード「マイナンバー」は CSV のヘッダー行にしかなく、そこから 50 文字を超える 3 行目以降はマッチしません。距離を 300 に広げると 10 件になりました。
私も一度は、距離 300 で作り直しかけました。ところが距離 50 のまま実ジョブを流すと、結果は 10 件、つまり全行検出です。電話番号の識別子も同じく、全行の 10 件を検出していました。
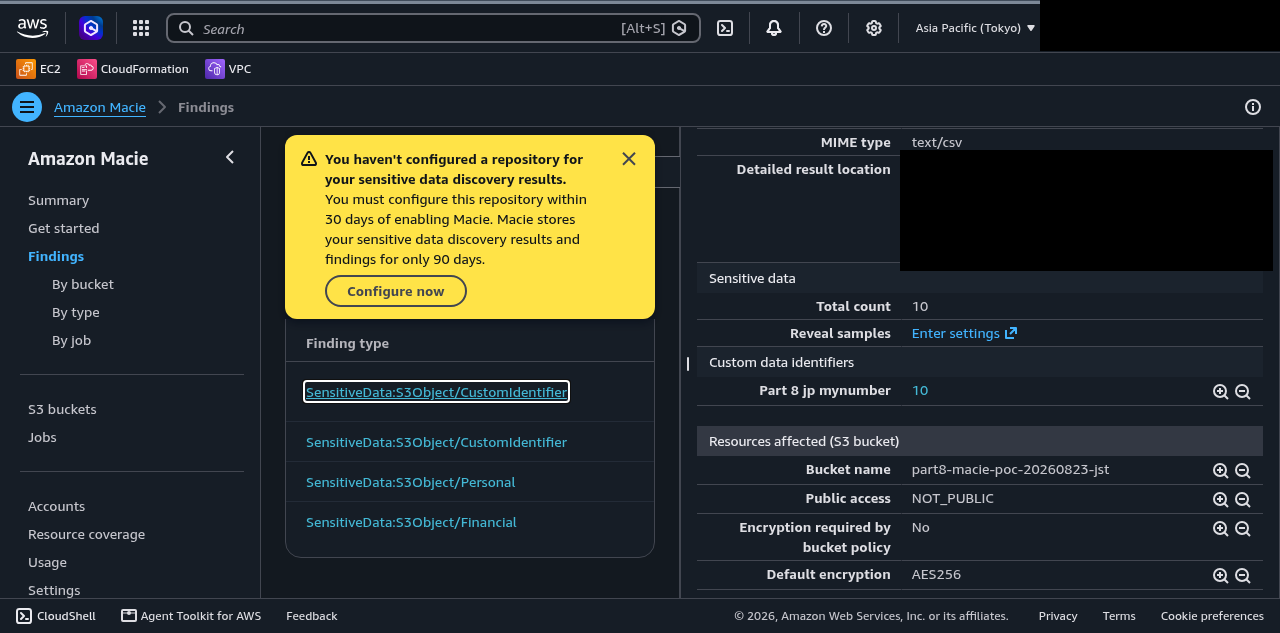
この差について、公式ドキュメントはこう説明しています。
Because Macie applies additional logic when processing structured records, the match count returned by the Evaluate box may differ in certain cases from the results produced by jobs.
(Macie は構造化レコードの処理時に追加のロジックを適用するため、Evaluate ボックスが返すマッチ数は、ジョブの結果と異なる場合があります)
追加ロジックの中身は公開されていませんが、観測からは、CSV のような構造化データでは列見出しのキーワードが列全体に効いているように見えます。教訓は単純で、test API の結果だけを見てキーワード距離を広げすぎないことです。距離を不必要に広げると、無関係な数値を拾う誤検出のリスクだけが増えます。チューニングの最終確認は実ジョブで行います。
負例の結果と、補いきれない領域
負例側は設計どおりでした。マイナンバーと同じ 12 桁の注文番号の列(ヘッダーは「注文番号」)も、キーワードなしの 12 桁数値列も、検出結果はゼロです。キーワードの近接条件は日本語でも効いています。ただし試した負例はこの 2 種類だけで、実データにはもっと多様な 12 桁の数値が現れるため、誤検出ゼロを一般化はできません。
限界はほかにもあります。まず、この正規表現は 12 桁の数字という形式しか見ていません。マイナンバーの検査用数字までは検証しないので、無効な 12 桁でもキーワードの近くにあれば拾います。次に、カスタム識別子の検出結果は severity が既定で Medium 固定です。件数がいくつでも変わらないため、件数に応じて severity を変えたい場合は、作成時に severity-levels で件数の閾値を指定します(これも作成後は変更できません)。
最後に、日本語の氏名と住所です。これは今回カスタム識別子を作りませんでした。氏名は正規表現で書ける形式パターンを持たないからです。任意の日本語文字列を拾おうとすれば日本語の文全体がマッチ候補になり、誤検出の山になります。形式を持たないデータの検出が要件なら、正規表現の外側、たとえば Amazon Comprehend のような自然言語処理のサービスを検討する領域です。ただし Comprehend も、個人情報に特化した検出機能は英語とスペイン語のみで、日本語で使えるのは人名や地名を拾う汎用のエンティティ検出までです。そのままの置き換えにはなりません。
分類を統制につなぐ(BP02 実測)
ここまでで、分類の基準を決める話(BP01、BP02)と、機密データを検出する話(BP03)が揃いました。しかし検出しただけでは、まだ何も守られていません。検出結果は「ここに機密データがある」と教えてくれますが、アクセスを制限するのは別の仕組みです。そして Macie は、検出結果に基づいてオブジェクトへタグを付けるところまではやりません。検出後の対応は利用者が組む前提で、BP03 の実装ガイダンス自身が自動修復の例として「ABAC を使っている場合はオブジェクトにタグを付ける」を挙げています。属性ベースのアクセス制御(ABAC)は、リソースのタグなどの属性で権限を決める方式です。分類と統制の間は、利用者がつなぎます。
そのつなぎの最小構成を実測しました。オブジェクトに classification=internal と classification=confidential のタグを付けます。そして、検証用ロールを用意します。持たせる権限は、条件キー s3:ExistingObjectTag/classification が internal に一致する場合だけ s3:GetObject を許可する、次の 1 文のみです。
{
  "Version": "2012-10-17",
  "Statement": [{
    "Sid": "AllowGetOnlyInternalTagged",
    "Effect": "Allow",
    "Action": "s3:GetObject",
    "Resource": "arn:aws:s3:::<バケット名>/*",
    "Condition": {
      "StringEquals": {"s3:ExistingObjectTag/classification": "internal"}
    }
  }]
}
このロールで 3 パターンの取得を試しました。
| オブジェクトのタグ | GetObject の結果 |
|---|---|
| classification=internal | 取得成功 |
| classification=confidential | AccessDenied |
| タグなし | AccessDenied |
結果そのものは地味です。ただ、注目したいのは 3 行目で、この構成ではタグが付いていないオブジェクトも拒否されます。ロールの権限は条件付きの許可 1 文だけなので、条件に一致しないアクセスはすべて暗黙の拒否に落ちます。分類タグの付与漏れが「なぜかアクセスできない」という形で確実に顕在化するので、タグ運用を徹底させる強制力として働きます。裏を返せば、BP01 の節で挙げた「未分類の扱い」を決めずにこの統制を入れると、タグのない既存オブジェクトへのアクセスが軒並み止まります。
なお、この挙動は、s3:GetObject を広く許可する別のポリシーと同居しない構成が前提です。既存の広い権限に条件付き許可を足しただけでは、この強制力は生まれません。もうひとつ、タグを統制の属性にするなら、タグを変更できる権限も統制の対象です。s3:PutObjectTagging を持つ利用者は、confidential タグを internal へ張り替えるだけで統制を迂回できます。タグの付与と変更の権限は、データを読む主体とは分けておきます。
ライフサイクルを分類スキームに含める(BP04)
最後の BP04 は、分類レベルごとのライフサイクル管理です。今回の実機検証では対象外にした領域です。
公式の望ましい状態は 2 つあり、どちらも時間軸の話です。データの分類とマスキングなどの加工は取り込みの時点と場所へ可能な限り近づけて行うこと、そして分類に基づく保持期間が過ぎたデータはポリシーどおりに削除することです。上流で機密度を下げるほど、下流に流れる機密データが減ります。
実装の道具は S3 ライフサイクルポリシー、Amazon Data Lifecycle Manager、DynamoDB の TTL、AWS Backup といった顔ぶれです。バックアップについて公式が挙げる注意は次の 3 点です。
- 利用可能なデータと区別して扱う
- S3 Object Lock や AWS Backup Vault Lock で改変から守る
- アカウントレベルで分離する
もうひとつ、データの来歴(どこから来て、誰がどう変換したか)の追跡も BP04 の範囲です。
BP01 の分類スキーム表と BP02 の統制対応表に「保持と破棄」を含めたのは、この BP04 のためです。レベルを決めるときに保持期間まで一緒に決めてしまえば、ライフサイクル設定は表からの転記で済みます。
いくらかかったか
シリーズ恒例の料金確認です。Macie の料金は 3 つの次元で決まります。
| 課金対象 | 単位 | 補足 |
|---|---|---|
| バケット評価 | 1 バケットあたり月 0.10 USD | 有効化するとリージョン内の全バケットが対象 |
| automated discovery | 監視オブジェクト数と検査量 | 30 日無料トライアルの対象 |
| 検出ジョブ | 検査量 1 GB あたり 1.00 USD | S3 の GET と LIST の料金も別途発生 |
単価は米国東部の例示値です。東京リージョンの単価は、ジョブ作成画面の最終ステップに出る見積もりで確かめられます。無料枠は 2 系統あって紛らわしいところです。30 日の無料トライアルの対象はバケット評価と automated discovery で、検出ジョブは含まれません。一方で検査量には月 1 GB の恒久無料枠が別にあり、こちらは期限がありません。この枠はジョブと automated discovery の検査量で共有され、翌月への繰り越しはありません。
今回の検証は、9 オブジェクト計 2.6 KB を 2 本のジョブでスキャンしただけです。実測費用を Cost Explorer で確認すると、内訳は次のとおりでした。
| 対象 | 実費 | 条件 |
|---|---|---|
| Amazon Macie(検出ジョブ) | 0 USD | 検査量 0.0000048 GB(約 5 KB)。月 1 GB の恒久無料枠内 |
| Amazon Macie(バケット評価) | 0 USD | 30 日無料トライアル内 |
| S3 リクエスト(東京) | 0.00012 USD | PUT/LIST 18 件、GET 97 件 |
合計は 0.00012 USD(1 円未満)です。検出ジョブは Usage ページ(コンソールの使用状況画面)の推定どおり 0 USD で、S3 の GET と LIST だけが Macie 料金の外で請求に載りました。検証の翌日以降、Macie の課金項目は出ていません。
ひとつ注意したいのは、Macie を有効化するとリージョン内の全バケットが棚卸し対象になることです。バケットが大量にあるアカウントでは、ジョブを流さなくてもバケット評価の費用が発生します。
本番規模では、検査量がそのまま費用になります(試算は、その月の無料枠を他で消費していない前提です)。
| シナリオ | 検査量 | ジョブ費用の目安 |
|---|---|---|
| 導入評価(今回の検証) | 数十 MB 以下 | 0 USD(恒久無料枠内) |
| 対象を絞ったスキャン | 100 GB | 約 99 USD |
| 全量スキャン | 2 TB | 約 2,000 USD |
2 TB の行は机上の掛け算ですが、実際に全量スキャンを検討して約 2,000 USD の試算に至った導入事例も公開されています。「Macie は高い」も「Macie は安い」も、検査量を決めるまでは成立しません。automated discovery のサンプリングで当たりを付けてから対象を絞ってジョブを流す公式の使い分けは、この費用構造への答えでもあります。
検証後は、バケットと IAM ロールとカスタムデータ識別子を削除し、Macie を無効化して、残存リソースがないことを確認しました。
まとめ
今回は SEC 7「データの分類」を、分類スキームの設計から実測まで通して読み解きました。
- 分類スキームを決める。レベルは 4 段階を出発点に、判断基準は漏えい時の影響で書く。未分類の扱いも先に決める(BP01)
- レベルごとの統制を表にする。全データ同一の統制はアンチパターン(BP02)
- 自動検出を入れる。ただし識別子の一覧を先に引く。日本固有の形式はカスタムデータ識別子で補い、氏名や住所のような形式のないデータは Macie の外で考える(BP03)
- 保持と破棄までスキーム表に含めて、ライフサイクル設定を表からの転記にする(BP04)
実測で印象に残ったのは、検出ゼロという同じ結果でも、重みが文脈でまったく変わることです。識別子のカバレッジを確認する前の検出ゼロは何の安心材料にもならず、確認した後の検出ゼロは、discovery results さえ残していれば監査の証跡になります。冒頭の「うちの S3 に個人情報は入っていないよね」に即答できなかったのは、ツールがなかったからではなく、分類の基準と検出器の守備範囲を決めていなかったからでした。ツールの結果を読む前に、ツールが何を見ているかを読む。SEC 7 が分類スキームの理解から始まる理由も、そこにあります。
次回の Part 9 では、SEC 8「保管中のデータの保護」を扱う予定です。今回の統制対応表で中身を先送りした暗号化と鍵管理の列を、KMS を軸に埋めていきます。
参考リンク
- SEC 7. How do you classify your data?
- SEC07-BP01 Understand your data classification scheme
- SEC07-BP02 Apply data protection controls based on data sensitivity
- SEC07-BP03 Automate identification and classification
- SEC07-BP04 Define scalable data lifecycle management
- Quick reference: Managed data identifiers by category
- Managed data identifiers recommended for jobs
- Creating a custom data identifier
- Running sensitive data discovery jobs
- Storing discovery results in Amazon S3
- Tagging and access control policies
- Amazon Macie pricing
- Amazon Macie FAQs

関連記事
-
 セキュリティの柱を改めて読み解いてみる – Part 2: アカウント設計とルート保護編(SEC 1)
-
 セキュリティの柱を改めて読み解いてみる – Part 3: 認証編(SEC 2)
-
 セキュリティの柱を改めて読み解いてみる – Part 4: 認可編(SEC 3)