
AWS Batchを「動かして理解」する
目次
AWS Batchを「動かして理解」する(CDK + Fargate + S3入出力)
こんにちは、Cloud Buildersのzumiです。
最近バックエンドを触ることが多くなり、「バッチ処理」や「バッチ適用」といった言葉を耳にする機会が増えました。
ただ正直なところ、バッチってなんやねん……となっていたので、そういえばAWSにも AWS Batch があったなと思い出し、理解のために手を動かしてみることにしました。
この記事は、AWS Batchの概念をさらっと押さえつつ、CDK(TypeScript)で最小の構成を作って実際に動かすところまでをまとめたものです。
この記事では、概念説明に寄りすぎず、CDK(TypeScript)で最小の動く構成を作って理解します。
今回の構成はCDKを利用しているため、試す場合以下からgit cloneしてください
この記事でやること
- S3入力 → 加工 → S3出力のバッチ処理をコンテナで実行する
- Job1 → Job2を
dependsOnでつなぎ、バッチっぽい「手順」を作る - 実行の起点を EventBridge(定期)→ Lambda(投入係)→ Batch にして、実務でよくある形に寄せる
AWS Batchとは何か
AWS Batchは、バッチジョブを効率的に実行するためのマネージドサービスです。
「バッチジョブ」とは、ユーザーからの即時レスポンスを必要としない、まとまったデータ処理を指します。
Batchが解決する課題
バッチ処理を自前で構築すると、以下のような課題があります:
- リソース管理: 処理量に応じてサーバーを増減させる必要がある
- ジョブキュー: 複数のジョブを順番に実行したり、同時実行数を制御したい
- リトライ・エラーハンドリング: 失敗したジョブを自動で再実行したい
- 依存関係の管理: 「前処理が終わったら後処理を実行」といった順序制御
AWS Batchは、これらを マネージドで提供 してくれます。
他サービスとの違い
| サービス | 用途 | 実行時間制限 | 適している処理 |
|---|---|---|---|
| Lambda | イベント駆動の短時間処理 | 最大15分 | API応答、軽いデータ変換 |
| ECS/Fargate | 長時間稼働するコンテナ | 制限なし | Webサーバー、常駐アプリ |
| AWS Batch | バッチ処理専用 | 制限なし(タイムアウト設定可) | データ集計、ML学習、動画変換 |
ポイント: Batchは「ジョブの実行管理」に特化しています。
ECSと同じくコンテナを使いますが、キューイング・リトライ・依存関係といったバッチ特有の機能が最初から組み込まれています。
AWS Batchの4大コンポーネント
Batchは、以下の4つの要素で構成されます。
1. Job Definition(ジョブ定義)
「どのコンテナを、どんなリソースで、どんな設定で動かすか」を定義します。
- コンテナイメージのURI(ECR)
- vCPU / メモリの要求量
- 環境変数(S3バケット名、処理モードなど)
- IAMロール(S3へのアクセス権限など)
- ログ設定(CloudWatch Logs)
**Job Definitionは「レシピ」**のようなもので、これ自体は実行されません。
実際に実行するときは、この定義を元に「Job」が作られます。
2. Job Queue(ジョブキュー)
「投入されたジョブを順番待ちさせる場所」です。
- 優先度(Priority)の設定が可能
- 複数のCompute Environmentを紐付けられる(優先順位付き)
- ジョブは「SUBMITTED → PENDING → RUNNABLE → STARTING → RUNNING」と状態が遷移
重要: ジョブは投入されるとキューに入り、リソースが空くまで待機します。
大量のジョブを一気に投入しても、Batchが順次さばいてくれます。
3. Compute Environment(コンピューティング環境)
「どこでジョブを実行するか」を定義します。
- Fargate: サーバーレス。起動は遅いが、管理不要
- EC2: 自前でインスタンスを管理。起動は速いが、運用が必要
今回はFargateを選択しました(サーバー管理不要、デモに最適)。
Compute Environmentには、以下を設定します:
- 最大vCPU数(同時実行可能な処理量)
- VPC/サブネット/セキュリティグループ
- IAMロール(Batch自体が使う権限)
4. Job(ジョブ)
「実行1回分」です。
- Job Definitionを元に作成される
SubmitJobAPIで投入すると、キューに追加される- 実行時に環境変数を 上書き できる(
containerOverrides) - 依存関係(
dependsOn)を指定すると、親ジョブ完了後に実行される
Batchがやってくれること・やってくれないこと
Batchがやってくれること
- ✅ ジョブのキューイングと順序制御
- ✅ リソースの自動プロビジョニング(Fargateの場合)
- ✅ 失敗時の自動リトライ(Retry Strategy)
- ✅ 依存関係の管理(
dependsOn) - ✅ ログの収集(CloudWatch Logs統合)
- ✅ ジョブの状態監視(コンソール/API)
Batchがやってくれないこと
- ❌ データ処理ロジック(コンテナ内のコードで実装)
- ❌ ジョブの投入タイミング(Lambda/EventBridge/アプリから投入)
- ❌ 複雑なワークフロー(複数ジョブの並列化や条件分岐は別途必要)
つまり、Batchは「実行基盤」であり、「何を処理するか」はコンテナ次第です。
今回の構成(デモ)
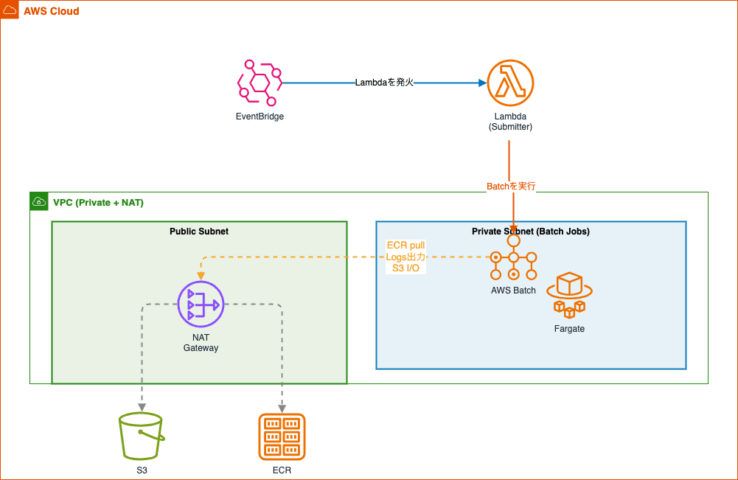
構成図
データフロー
- input:
s3://<bucket>/input/sample.txt - intermediate:
s3://<bucket>/intermediate/<runId>.json - output:
s3://<bucket>/output/<runId>.json
実行フロー
- EventBridge: 15分ごとに起動(任意)
- Lambda(SubmitterFn): Job1とJob2をBatchに投入(Job2には
dependsOn=Job1) - AWS Batch(Fargate): ECRからイメージをpullしてコンテナ実行
- CloudWatch Logs: ジョブログ(進捗を一定間隔で出す)
環境構築
前提条件
この構成を動かすには、以下が必要です。
- Node.js(推奨: v20以上)
- AWS CLI(設定済み:
aws sts get-caller-identityが通る状態) - AWS CDK(初回のみ
npx cdk bootstrapでbootstrap) - コンテナビルド環境(Docker または Podman)
- CDKが
DockerImageAssetでローカルビルド→ECRへpushするため
- CDKが
セットアップ手順
# リポジトリのクローン(または準備)
cd cdk-batch
npm install

# 初回のみ(アカウント/リージョンごと)
npx cdk bootstrap

# デプロイ
npx cdk deploy

# Podmanを使う場合
CDK_DOCKER=podman npx cdk deploy
デプロイが完了すると、BucketName、JobQueueArn、SubmitterFunctionName などが出力されます。
デプロイ後の確認
デプロイが成功したら、マネコンで各リソースを確認してみましょう。
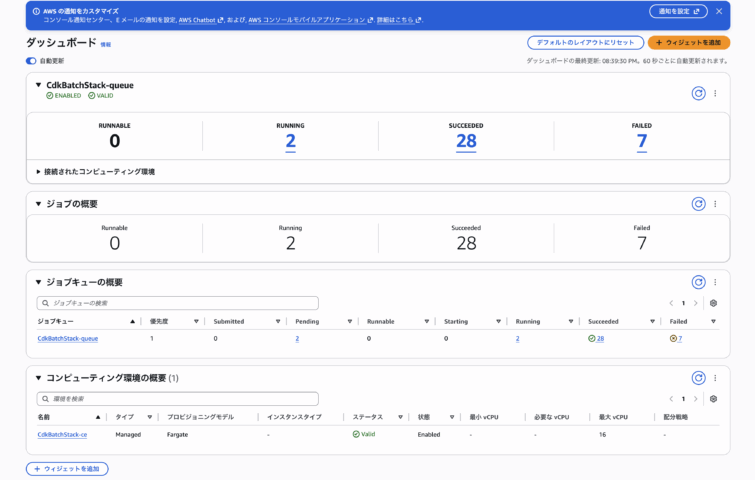
ダッシュボードでジョブキューの概要であったりがみれます。個人でカスタマイズ可能なので、みやすいように機能の追加を行えます。
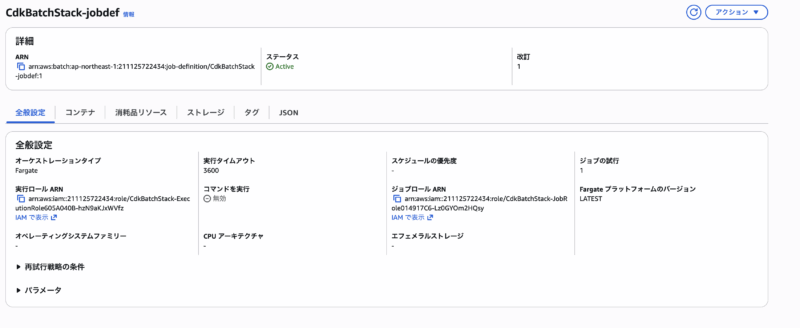
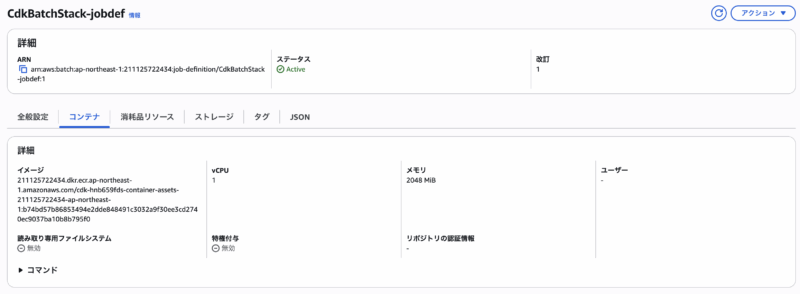
「ジョブ定義」から作成された定義を選択すると、コンテナイメージURI、vCPU/メモリ、環境変数、IAMロールなどが確認できます。
この画面で「どんな設定でコンテナが動くか」が一目でわかります。
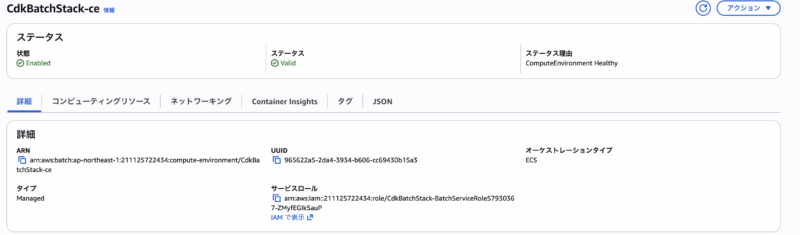
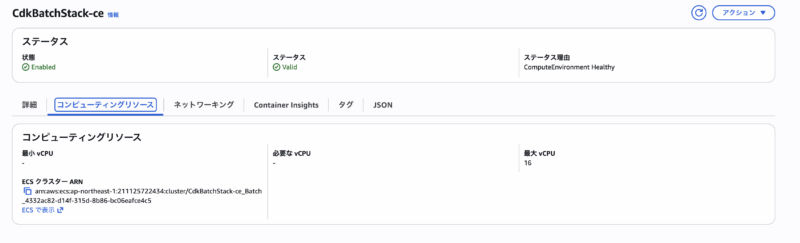
「コンピューティング環境」では、Fargateの設定、最大vCPU数、VPC/サブネット、セキュリティグループが確認できます。
この画面で「どこでジョブが実行されるか」がわかります。
入力ファイルの準備
aws s3 cp sample/sample.txt s3://<BucketName>/input/sample.txt
実装のポイント(なぜLambdaがいる?)
Batchは「ジョブ実行基盤」なので、**”誰がいつ/どうやってジョブを投入するか”**は別で用意することが多いです。
今回は理解を優先して、Lambda(SubmitterFn)が次を行います。
runIdを作る(出力ファイル名の衝突を避ける)- Job1(
MODE=preprocess)をSubmitJob - Job2(
MODE=postprocess)をSubmitJob(dependsOnで Job1完了後に実行)
重要なのは、LambdaがJob1の完了を待ってからJob2を起動するわけではないこと。
Lambdaは **「2ジョブを投入してすぐ終了」**し、依存関係の解釈と順序制御はBatch側がやります。
つまずきポイント(実際にハマった)
1) jobName には命名規則がある
Batchの jobName は何でもOKではなく、使える文字に制限があります。runId に . などが混ざると Job name should match valid pattern で失敗します。
→ 対策は 英数字 + -/_ のみに寄せる。
2) ResourceInitializationError(ECRに到達できない)
Fargateジョブは起動時に ECRへアクセスしてイメージをpullします。
VPCの外向き通信が無いと、ECRの GetAuthorizationToken でタイムアウトして起動前に落ちます。
今回のデモは「よくある前提」に寄せて、Private Subnet + NAT Gateway で解決しました。
(閉域に寄せるなら、VPCエンドポイントをきちんと揃える必要があります。参考:ECS on FargateのResourceInitializationError解説)
3) DockerImageAsset を使うなら、ローカルにコンテナビルド環境が必要
CDKがローカルでイメージをビルドしてECRにpushします。
自分はPodman環境だったので、次で動かしました。
CDK_DOCKER=podman npx cdk deploy
4) Batchのコンテナイメージは「ECR」に置く必要がある
これは正直びっくりしました。
Batchはコンテナベースなので、実行するイメージを事前にECRに登録しておく必要があります。
ECSと同じく、Batch実行時にECRからイメージをpullする仕組みです。
最初は「Batchにコードをアップロードする感覚」をイメージしていたのですが、実際は 「ECRにイメージを置いて、BatchがそれをpullしてFargate/EC2で実行する」 という流れでした。
CDKの DockerImageAsset を使えば、このあたりは自動化されます(ローカルビルド → ECRへpush → Job DefinitionにURI自動設定)。
動かし方(最短)
デプロイ後、出力される BucketName に入力を置きます。
aws s3 cp cdk-batch/sample/sample.txt s3://<BucketName>/input/sample.txt
すぐに動かしたい場合は、Lambdaを手動で実行します。
aws lambda invoke --function-name <SubmitterFunctionName> /tmp/out.json && cat /tmp/out.json
成功すると、S3に成果物が出ます。
s3://<BucketName>/intermediate/s3://<BucketName>/output/
実行結果の確認
Lambda実行後、マネコンで実際の動きを確認してみましょう。
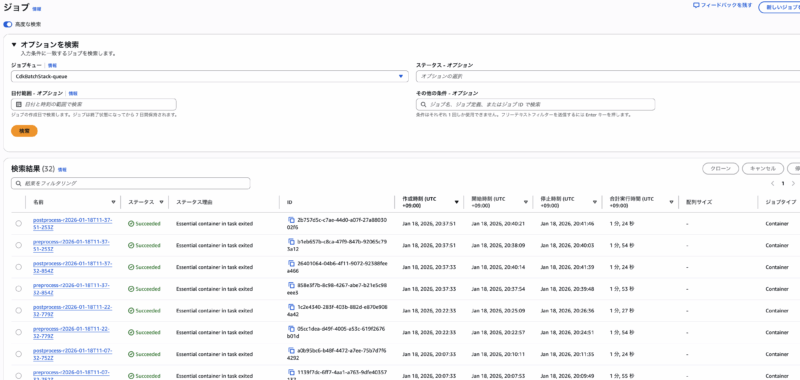
「ジョブ」タブで、投入された2つのJob(preprocess / postprocess)が確認できます。
少し見づらいですが、preporocessの後、postprocessが実施されています。
ステータスが「SUCCEEDED」になっていれば成功です。
Job1が完了してから、Job2が実行される様子がタイムスタンプで確認できます。
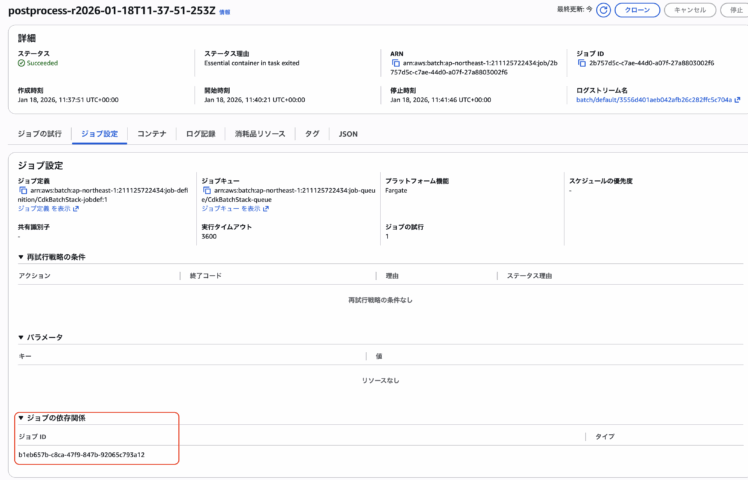
postprocessジョブの詳細画面を開くと、「ジョブの依存関係」欄に親ジョブ(preprocess)のID(b1eb657b-c8ca-47f9-847b-92065c793a12)が表示されています。
これで、Batch側が依存関係を管理していることが確認できます。
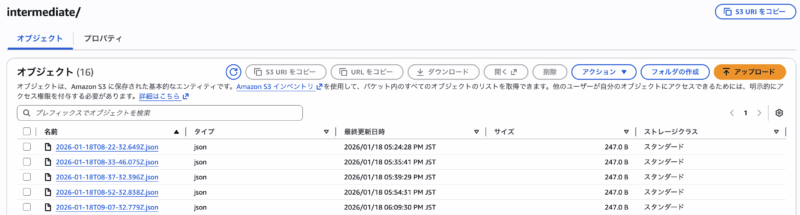
#intermidiateの中身
{
  "run_id": "2026-01-18T08-22-32.649Z",
  "input": {
    "bucket": "cdkbatchstack-databuckete3889a50-ja6mx0jgplp1",
    "key": "input/sample.txt"
  },
  "metrics": {
    "line_count": 3
  },
  "generated_at": "2026-01-18T08:24:27.242162+00:00"
}
S3コンソールで intermediate/ フォルダを開くと、Job1が出力したJSONファイルが確認できます。
ファイル名には runId が含まれており、実行ごとに別ファイルになっています。
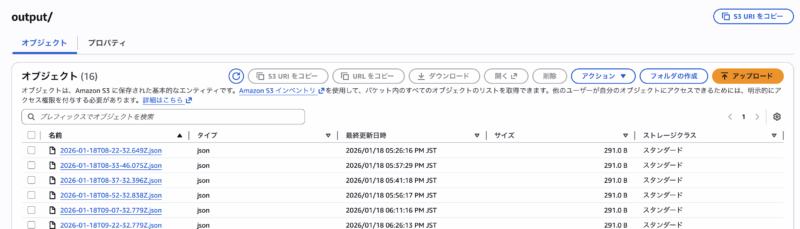
#outputの中身
{
  "run_id": "2026-01-18T08-22-32.649Z",
  "status": "ok",
  "source": {
    "bucket": "cdkbatchstack-databuckete3889a50-ja6mx0jgplp1",
    "key": "intermediate/2026-01-18T08-22-32.649Z.json"
  },
  "result": {
    "line_count": 3
  },
  "generated_at": "2026-01-18T08:26:15.326794+00:00"
}
output/ フォルダには、Job2が処理した最終成果物が格納されています。
このように、S3を介してジョブ間でデータを受け渡すパターンが確認できます。
まとめ
理解のポイント
- **Batchは「ジョブをさばく実行基盤」**で、データ処理はコンテナ内のコードが行う
- dependsOn で「前処理→後処理」のような簡単な依存関係は作れる(軽いオーケストレーション要素)
- 実務では EventBridge/Lambda/アプリ/CI などからジョブ投入するのが一般的
- コンテナイメージはECRに置く必要があり、Batch実行時にpullされる
実体験:Lambdaで困ったケース
以前、Lambda関数で重めの処理を実装したとき、実行時間が15分を超えてタイムアウトしてしまったことがありました。
当時は「処理を分割して複数Lambda」や「Step Functionsで細かく制御」などで対応しましたが、今回Batchを触ってみて、あのケースはBatchの方が適していたかもしれないと気づきました。
Batchが向いていたと思う理由:
- 実行時間の上限(Lambdaは15分、Batchは時間制約が緩い)
- 処理が重く、必要なライブラリも多かった(コンテナで環境を固定できる)
- 失敗時の再実行がジョブ単位で明確にできる
もちろん構成の複雑さとのトレードオフはありますが、「長時間/重い処理」ならBatch、「短い/イベント駆動」ならLambda、という使い分けの指針が体感できました。
(参考:AWS公式の「AWS Batchとは」:AWS Batch ユーザーガイド)
