
AWS MCPサーバにトラブルシューティングをさせてみる
目次
はじめに
こんにちは、CloudBuildersのktakedaです。
2025/11/30にAWSよりマネージド型のAWS MCP サーバの発表されました。
AWS が AWS MCP サーバーのプレビュー版を発表 – AWS
従来では、各サービスやカテゴリごとのAWS MCP サーバを追加する必要がありましたが統合されたAWS MCP サーバの登場により機能ごとのMCPサーバを意識すること無く、アカウント内の各サービスに関するタスクを行うことができるようになりました。
試しに、意図的に問題のあるLambdaを作成したのでAWS MCPサーバを用いてAIアシスタントにトラブルシューティングをさせてみようと思います。
トラブルシューティング対象の環境
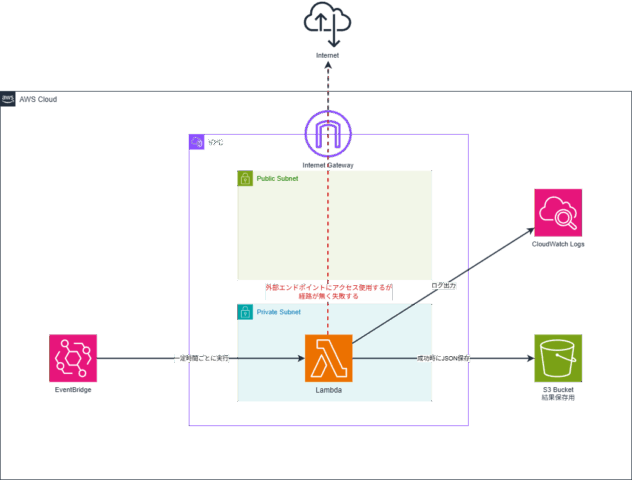
外部APIを呼び出すLambda処理を見立てて下記の構成を作りました。
簡易的ですが処理内容としてはEventBridgeにて一定期間ごとにLambdaを呼び出し、Lamdbaではインターネット上のエンドポイントをたたいてその結果をS3に格納するものになります。
構成上では、Lamdbaをプライベートサブネットに設置しておりますが、NAT Gatewayが無いのでLambdaがインターネット上にアクセスすることができずLambdaはタイムアウトしてしまいます。
CloudWatch Logs上には下記のように出力させています。
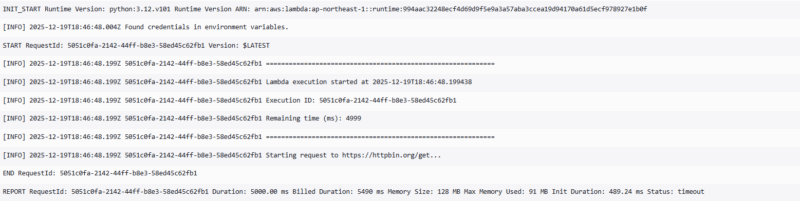
5秒で処理が終了していますがLambdaのタイムアウトを5秒に設定しているためです。

トラブルシューティングさせてみる
それでは、トラブルシューティングをさせてみます。MCPクライアントにはCursorを使っています。設定方法等についてはこの記事内では割愛させていただきますが必要なライブラリの用意とファイルへの定義と認証情報の取得のみで用意は大変ではありませんでした。
プロンプトを投げる
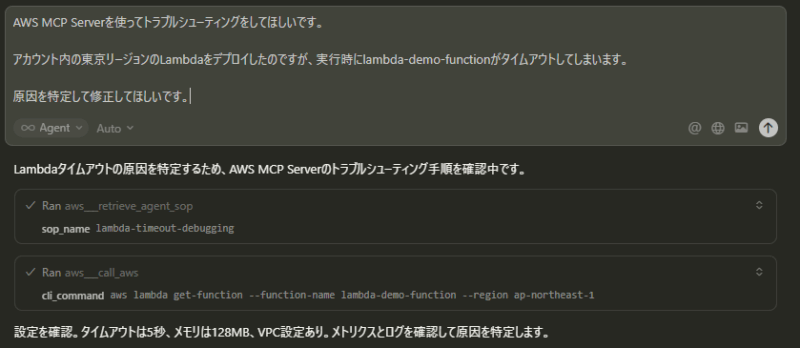
今回はなるべくAIアシスタント側に任せてみたかったので簡単に下記のプロンプトで指示を出してみました。
問題のあるLambdaの名前とタイムアウトとなっている状態だけを伝えています。
AWS MCP Serverを使ってトラブルシューティングをしてほしいです。

アカウント内の東京リージョンのLambdaをデプロイしたのですが、実行時にlambda-demo-functionがタイムアウトしてしまいます。

原因を特定して修正してほしいです。
SOP呼び出しとLambda情報収集
プロンプトを投げてみると、早速 aws___retrieve_agent_sopからlambda-timeout-debuggingというSOPが呼び出され、かつ指定したLambda関数について aws___call_awsにてAWS APIへの呼び出しが行われ設定情報が取得されました。
Lambdaのタイムアウトの対応については自動化手順が予め用意されているようです。確認した内容としてタイムアウト値やメモリ、VPC設定がレスポンスに記載されておりました。これらがSOP側で確認すべき内容として指定されているのでしょうか。
CloudWatchのメトリクスとログ確認
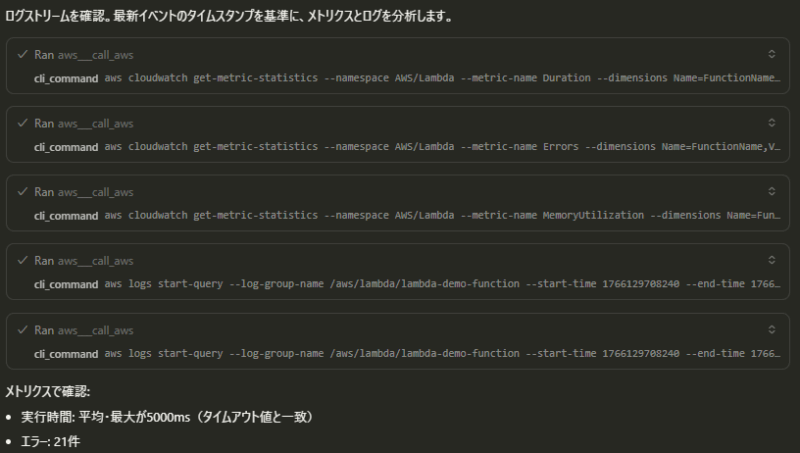
次の対応としてはCloudWatch上のメトリクスとログの確認が実施されました。どちらも実行時間が5000msでタイムアウト値と一致していると指摘されています。
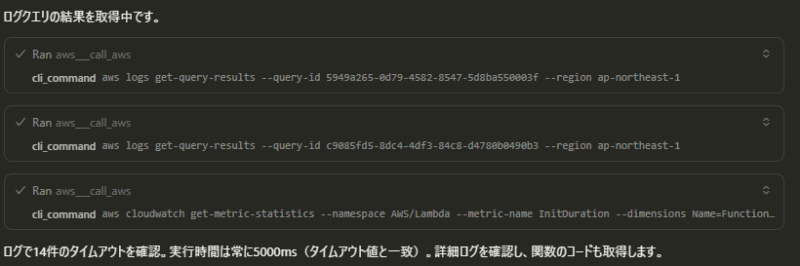
Lambda関数のコードとVPC設定の確認
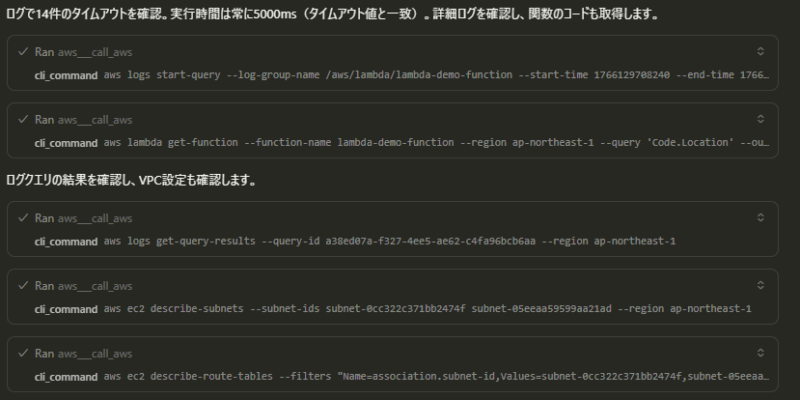
その後、関数内の中身とVPC設定の確認が行われました。関数内にて外部のエンドポイントにリクエストを送っている処理が書かれているからか、VPC上の設定についても確認をするようです。
VPC上の設定確認としてはサブネットの情報とルートテーブルの情報を取得しています。
NAT Gatewayがないことが原因なので、どんどんと核心に迫っているように感じます。
原因の特定
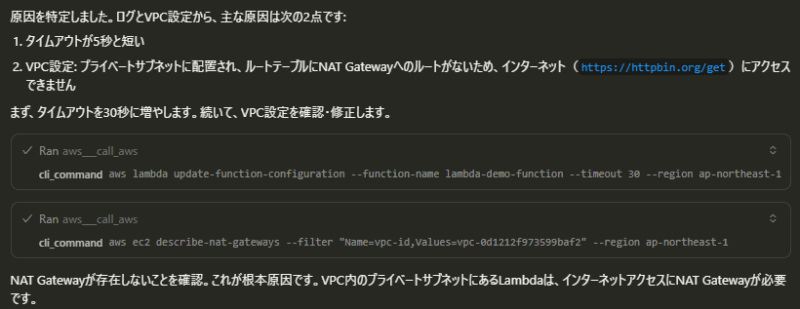
原因の特定ができたようです。考えられる原因として、タイムアウト値の短さとLambda側のインターネットへの経路がないことが指摘されています。
プライベートサブネットのLambdaにインターネットへの経路がないことが一番優先度の高そうな問題のような気もしますが、ひとまずタイムアウト値も原因の可能性があるとして変更してくれました。
Nat Gatewayの作成条件の確認
解決策として、VPCエンドポイントかNAT Gatewayの作成が挙げられているようです。VPCエンドポイント側は通信先が外部インターネットではなくAWSサービス内などの考慮なのでしょうか。
NAT Gatewayでの解決策としてパブリックサブネットがありInternet Gatewayも既にあるのでNAT Gatewayの作成による方針になりそうです。
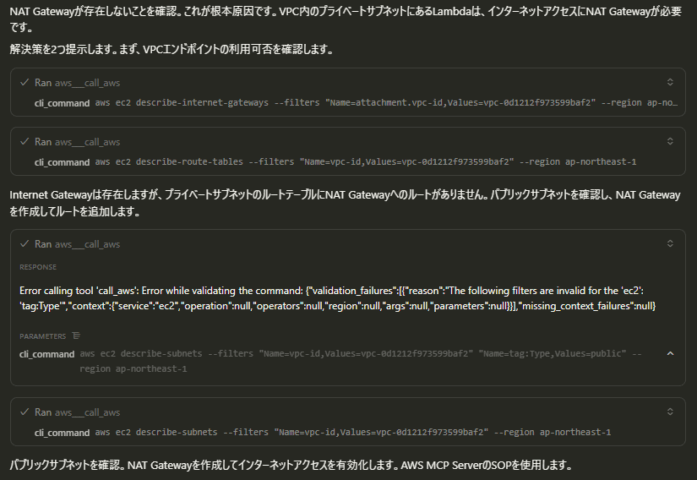
上記画像内にて、エラーとなる実行がありました。エラー内容は下記となりますが call_aws側で 'ec2': 'tag:Type'というフィルター条件が認められておらずバリデーションチェックに引っかかっていたようで、API側のエラーのレスポンスではないようでした。
Error calling tool 'call_aws': Error while validating the command: {"validation_failures":[{"reason":"The following filters are invalid for the 'ec2': 'tag:Type'","context":{"service":"ec2","operation":null,"operators":null,"region":null,"args":null,"parameters":null}}],"missing_context_failures":null}SOP確認とNAT Gateway作成
VPC内Lambdaのインターネットアクセスに関するSOPを確認の上、NAT Gatewayの作成に移りました。
しかし、タグ指定の問題で NAT Gatewayの作成に失敗。予め用意された手順をもってしても失敗するときはあるようです。
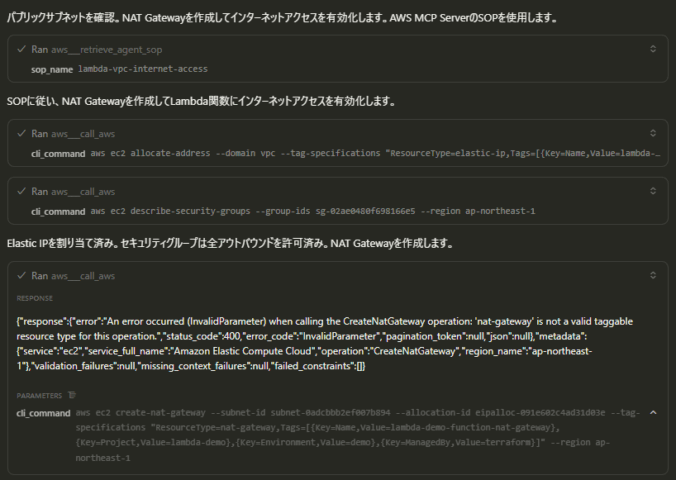
次の実行では、問題のあった個所を修正しNat Gatewayの作成に成功しました。(SOP側を確認してみるとNatGateway作成用のコマンドにタグに関する指定はありませんでした。AI側で勝手に付け足してしまったのでしょうか。)
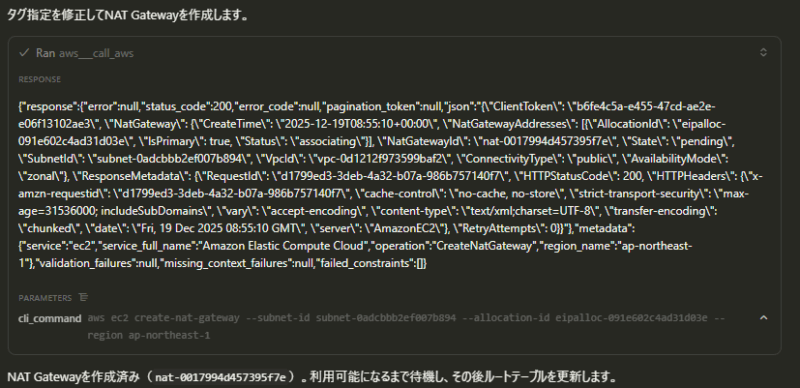
NAT Gatewayの利用可能待ち
最後にNAT Gatewayの利用可能になるのを待っていましたが時間がかかっており、ルートテーブルにNAT Gatewayの経路を追加し終了となりました。
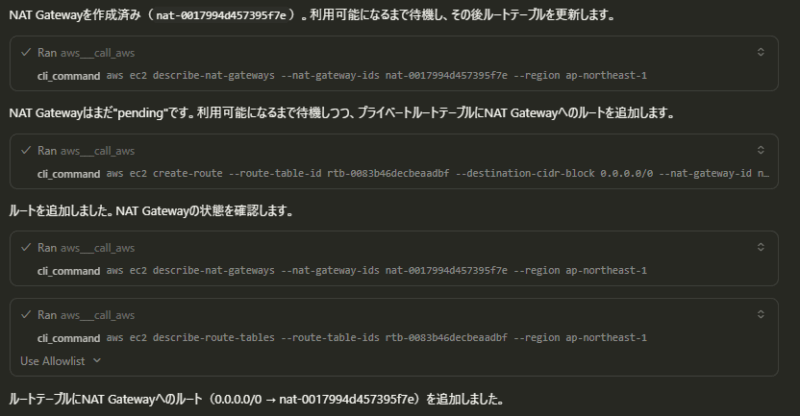
最終的なレスポンス
最終的なレスポンスとして下記が返ってきました。修正した箇所だけではなく、問題がなかった点や追加したリソースについての注意点としてコスト面の記載もありました。
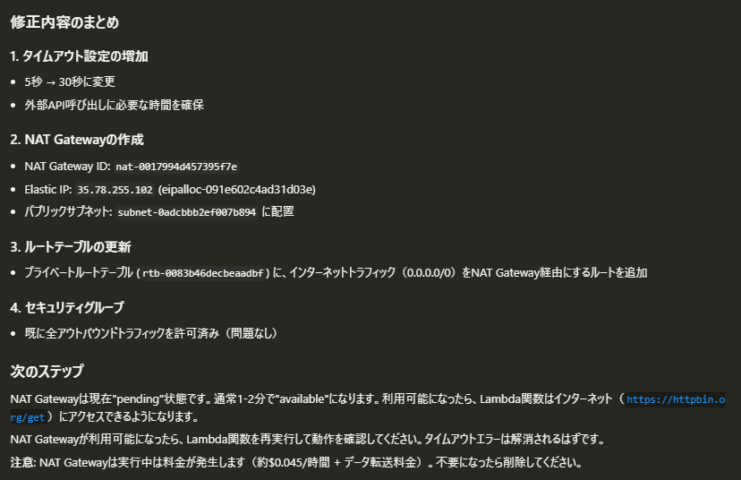
トラブルシューティングの結果
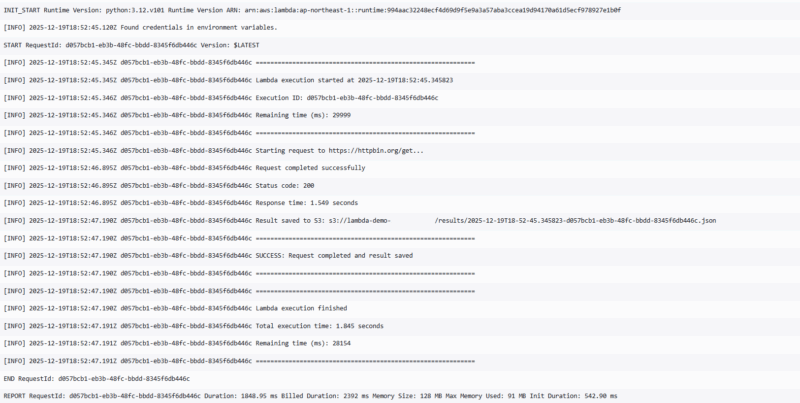
CloudWatch Logsを見に行くとログ出力が変わっており1秒程度で処理が完了するようになっていました。
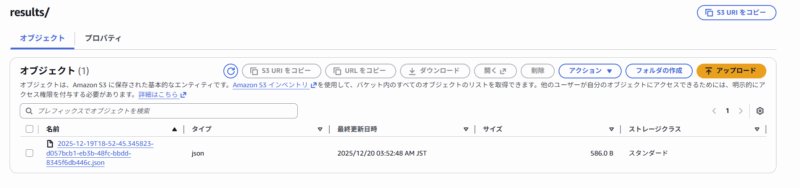
また、S3にもファイルがアップロードされるようになってました。
SOP:lambda-timeout-debuggingについて
トラブルシューティング開始時、lambda-timeout-debuggingというSOPを読み込んでいました。この文書ではLambda関数のタイムアウト失敗を調査する手順が記載されているのですがざっくり下記のような手順のようです。
- 依存関係の確認 – 必要なツール(call_awsなど)の可用性を確認
- 関数設定の取得 – タイムアウト、メモリ、ランタイムなどの設定を確認
- CloudWatchメトリクスの分析 – 実行時間、エラー、メモリ使用率の傾向を確認
- ロググループの確認 – ロググループの存在と利用可能な時間範囲を確認
- CloudWatchログの分析 – タイムアウト関連エラーとパフォーマンスパターンを検索
- ログクエリ結果の待機 – クエリ完了を待ち、結果を取得
- 関数コードの分析(オプション) – コード内のタイムアウト要因を特定
- 関数依存関係の分析 – VPC設定や外部サービス依存を確認
- 関連AWSサービスの確認 – RDS、DynamoDBなどの関連サービスの問題を調査
- コールドスタートパターンの分析 – コールドスタートがタイムアウトに与える影響を確認
- 推奨事項の生成 – 特定の問題に基づいた具体的な推奨事項を作成
- 分析レポートの作成 – すべての調査結果を統合したレポートを作成
トラブルシューティングで実施していた流れを振り返ると確かにこの手順に沿って進められていたと思います。こうしたナレッジを簡単に呼び出して適切に対応してくれるのはとても魅力的に感じました。
さいごに
今回は、タイムアウトしてしまうLambdaをAWS MCP サーバを用いてトラブルシューティングをしてみました。
AIアシスタント側が最初に与えられた少ない情報の中から一つ一つ情報を集めていって原因を特定していく流れが純粋に見てて面白かったです。
また今回の題材であったタイムアウトするLambdaについてはSOPが用意されていたのでそれ通りにトラブルシューティングをできてしまいましたが、より複雑な問題では複数のSOPを試したりなどどう対応していくのか気になりました。
ここまでご覧いただきありがとうございました。
