
ECS/EKSのAuto Scaling

目次
はじめに
こんにちは。CloudBuildersのじんです。今回はECS/EKSのAuto Scalingについて、まとめてみたいと思います。
AWSのコンテナオーケストレーションサービスECS/EKSですが、コンテナの実行基盤となるコンテナインスタンス(ECS)/ノード(EKS)のレイヤとコンテナを実行するタスク(ECS)/ポッド(EKS)のレイヤでのAuto Scalingがあり、それぞれ下記のようなAuto Scalingがあります。
| サービス | レイヤ | Auto Scaling方式 |
| ECS | インスタンス | Cluster Auto Scaling |
| タスク(サービス) | Service Auto Scaling | |
| EKS | ノード | Karpenter |
| Cluster Autoscaler | ||
| ポッド(Deployment) | Horizontal Pod Autoscaler | |
| Vertical Pod Autoscaler |
コンテナ実行時のスケール戦略を考える場合、EC2を動作環境としている場合は、タスクやポッドがスケールしようとしても、それが動作しているEC2(インスタンス/ノード)のキャパシティが足らなければ、スケールできないことになるため、両方のレイヤを考える必要があります。FargateではインスタンスやノードのAuto Scalingを意識する必要はないので、タスクやポッドのAuto Scalingを考えればよいことになります。
ECS:Cluster Auto Scaling
起動タイプをEC2で使う場合のみ使用します。このため、Fargateを使う場合は、Cluster Auto Scalingについては、対象外となります。
Cluster Auto Scalingの設定
クラスタ作成時に、Auto Scalingグループを指定します。EC2のAuto Scalingを使用するので、最小、最大のインスタンス数を設定します。

キャパシティプロバイダー側でスケーリングのTargetCapacityを指定します。

TargetCapacityはCapacityProviderReservation(必要なキャパシティ/現在動いているインスタンスの割合)というメトリクスのしきい値で、大雑把に言えば、100より少なければ早めにスケーリングし、100より大きければキャパシティが足らなくなってからスケールする、という感じです。


CloudFormationの場合は、下記リンクにサンプルがあります。AWS::AutoScaling::AutoScalingGroupとAWS::ECS::CapacityProviderのResource部分です。MinimumScalingStepSize,MaximumScalingStepSizeについては、GUIでの設定はできません。

        "ECSAutoScalingGroup": {
            "Type": "AWS::AutoScaling::AutoScalingGroup",
            "DependsOn": [
                "ECSCluster",
                "EC2Role"
            ],
            "Properties": {
                "VPCZoneIdentifier": {
                    "Ref": "SubnetIds"
                },
                "LaunchTemplate": {
                    "LaunchTemplateId": {
                        "Ref": "ContainerInstances"
                    },
                    "Version": {
                        "Fn::GetAtt": [
                            "ContainerInstances",
                            "LatestVersionNumber"
                        ]
                    }
                },
                "MinSize": 0,
                "MaxSize": {
                    "Ref": "MaxSize"
                },
                "DesiredCapacity": {
                    "Ref": "DesiredCapacity"
                },
                "NewInstancesProtectedFromScaleIn": true
            },
            "UpdatePolicy": {
                "AutoScalingReplacingUpdate": {
                    "WillReplace": "true"
                }
            }
        },
        "CapacityProvider": {
            "Type": "AWS::ECS::CapacityProvider",
            "Properties": {
                "AutoScalingGroupProvider": {
                    "AutoScalingGroupArn": {
                        "Ref": "ECSAutoScalingGroup"
                    },
                    "ManagedScaling": {
                        "InstanceWarmupPeriod": 60,
                        "MinimumScalingStepSize": 1,
                        "MaximumScalingStepSize": 100,
                        "Status": "ENABLED",
                        "TargetCapacity": 100
                    },
                    "ManagedTerminationProtection": "ENABLED"
                }
            }
        },
Cluster Auto Scalingの留意点
公式のペストプラクティスをまず確認することをお勧めします。

デフォルトの状態では、CPU/メモリよりも先にENI数の制限があるため、VPC Trunkingを有効にしておく必要があります。

タスク定義でタスクのvCPUとメモリの値を指定するが、このタスクサイズでインスタンスのvCPU or メモリを割って小さいほうがインスタンスで動作できるタスク数となります。なお、起動タイプがEC2の場合はメモリのみの指定とすることもでき、効率的にタスクを動かすことができるがCPUのバーストは負荷テストで要確認です。また、メモリはEC2の動作でオーバーヘッドがあるため、インスタンスのスペックをすべて使えるわけではありません。
Auto Scalingは、タスクの増加により必要なインスタンス数を計算するため、タスクの配置や後で触れるECS Service Auto Scalingとの兼ね合いで設計、動作確認をしておく必要があります。レスポンスタイムを保つための考え方としては、EC2のスケールは時間がかかるため、Cluster Auto Scalingでキャパシティ戦略を工夫するよりも、ECS Service Auto Scalingのスケジュールや予測スケーリングでタスクを予め増やすことによりインスタンスをスケールさせます。
タスクの配置はデフォルトではAZに分散する設定(attribute:ecs.availability-zoneを使用したspread)になっており、インスタンスに均等にタスクが動作する設定になっています。また、スケールインの動作のためには、AZを使用するbinpackも検討する必要があります(spreadの場合は、タスク数<インスタンス数とならないとスケールインしない)。

スケールアウトのCapacityProviderReservationの判断は1分 x1回となるが、スケールインは1分 x15回となります。
Cluster Auto Scalingの確認方法
コンテナインスタンスは、作成当初はAuto Scalingグループで最小数または必要な台数で起動します。Auto Scalingのみの動作を確認するには、サービスで、必要なタスク数を増やして動作を確認します。実際の動作を確認するには、後で触れるECS Service Auto Scalingを設定し、ツールやコマンド等で負荷をかけて確認します。
マネージメントコンソールでは、クラスター>クラスタ名>インフラストラクチャタブでキャパシティプロバイダーに現在のサイズ、必要なサイズ、最小サイズ、最大サイズで確認できます。必要なサイズが、ECSで認識しているリソースから割り出した必要なインスタンス数です。現在のサイズが実際起動しているインスタンス数で、起動してクラスタに認識されたインスタンスは、同じタブでコンテナインスタンスとして表示されます。コンテナインスタンスに使用可能なCPU、使用可能なメモリが表示されます。

TargetTracking-クラスタ名-から始まるアラーム名で、CapacityProviderReservationの値によってスケールアウトさせるアラームとスケールインさせるアラームがあります。
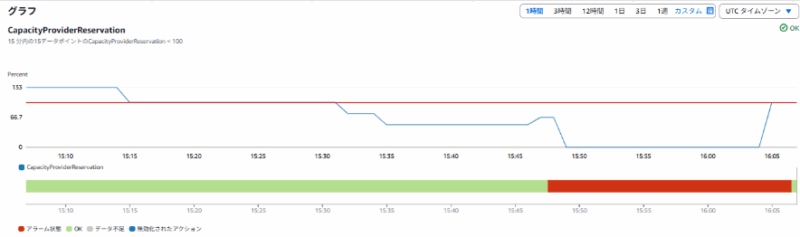
Auto Scalingの動作は、Auto Scalingグループのアクテビティ履歴で確認できます。
CLIでコンテナインスタンスを表示させる場合は下記となります。
$ aws ecs list-container-instances --cluster clusternam  --query 'containerInstanceArns' --output json

[
    "arn:aws:ecs:ap-northeast-1:123456789012:container-instance/test-ecs-app-cluster/38b7f319e1cf4f04a8df475b02cc1d97",
    "arn:aws:ecs:ap-northeast-1:123456789012:container-instance/test-ecs-app-cluster/66a926a212534befbe1e60cc815e19b5"
]
キャパシティプロバイダーの必要な数を表示するには下記となります。
$ aws ecs describe-container-instances \
  --cluster test-ecs-app-cluster \
  --container-instances $instance \
  --query 'containerInstances[0].{RunningTasks:runningTasksCount,PendingTasks:pendingTasksCount,AvailableCPU:remainingResources[?name==`CPU`].integerValue,AvailableMemory:remainingResources[?name==`MEMORY`].integerValue,Status:status}'

{
    "RunningTasks": 1,
    "PendingTasks": 0,
    "AvailableCPU": [
        1792
    ],
    "AvailableMemory": [
        3323
    ],
    "Status": "ACTIVE"
}
ECS:Service Auto Scaling
Service Auto Scalingは、タスクレベルのAuto Scalingを行います。下記に挙げる4種類があります。
ターゲット追跡スケーリング
メトリクスに対してターゲット値になるようにタスクをスケールします。
対象のメトリクスはECSServiceAverageCPUUtilization、ECSServiceAverageMemoryUtilization、ALBRequestCountPerTargetが対象となるので、CPU使用率、メモリ使用率、ターゲット毎のリクエスト数の目標値になるようにスケールする、ということになります。
ステップスケーリング
メトリクスの値に対して、段階的にインスタンスを数または割合を指定して増やしていく方法です。メトリクスは、CPUUtilizationかMemoryUtilization、スケールの単位はタスク数か割合(現在のタスク数に対して、何%のタスクを増やす/減らすか)になります。
スケジュールスケーリング
繰り返しまたは1度のスケジュールに従いタスクの最小数、最大数を調整します。
予測スケーリング
過去の負荷傾向から負荷予測を行い、ターゲットの値となる予想よりも指定した時間だけ事前(0秒~60分)にスケールアウトします。使用できるメトリクスはターゲット追跡と同じですが、2つのメトリクスを需要予測とスケーリング予測として使うことができます。スケールアウトのみでスケールインは不可です。
Service Auto Scalingの設定
最初にService Auto Scalingを有効にする必要があります。マネージメントコンソールでは、タスク設定時か、クラスター>クラスタ名>サービスタブ>サービス名>サービスの自動スケーリングタブでタスクの最小数、最大数を指定して自動スケーリングを有効にします。
なお、CloudFormationで設定する場合は、下記を参考に設定します。

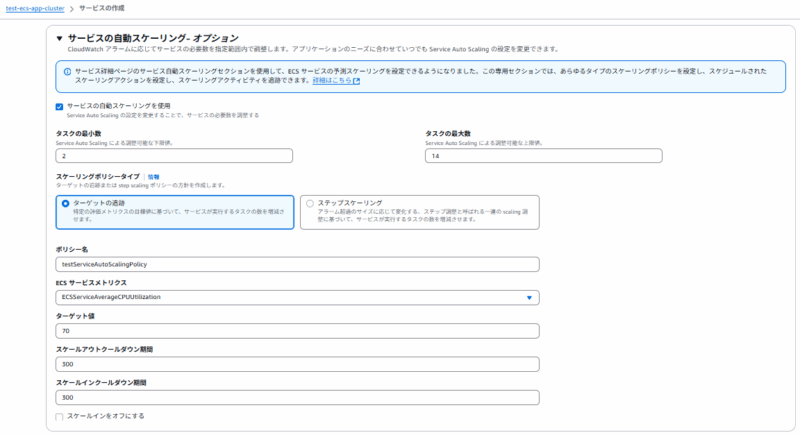
ターゲット追跡スケーリング
マネージメントコンソールでは、タスクを作成する時に設定するか、タスク設定後にクラスター>クラスタ名>サービスタブ>サービス名>サービスの自動スケーリングタブのスケーリングポリシーで作成します。
ステップスケーリング
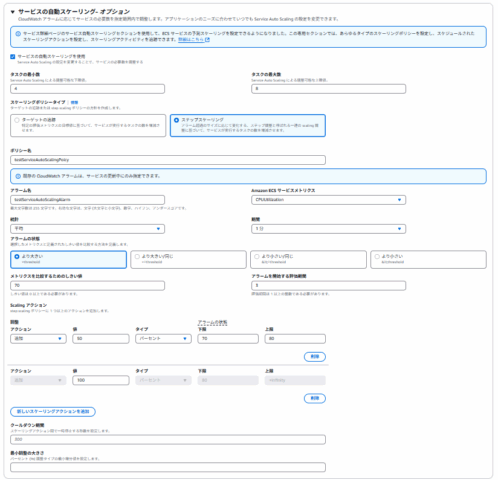
マネージメントコンソールでは、タスクを作成する時に設定するか、タスク設定後にクラスター>クラスタ名>サービスタブ>サービス名>サービスの自動スケーリングタブのスケーリングポリシーで作成します。
スケールアウトとスケールインでそれぞれ設定が必要ですが、タスク作成時は1つの設定のみ作成可能です。
スケジュールスケーリング
マネージメントコンソールでは、タスク設定後に設定できます。クラスター>クラスタ名>サービスタブ>サービス名>サービスの自動スケーリングタブのスケジュールされたアクションタブで作成します。
スケールアウトとスケールインをともにスケジュールしたい場合は、それぞれ作成します。

予測スケーリング
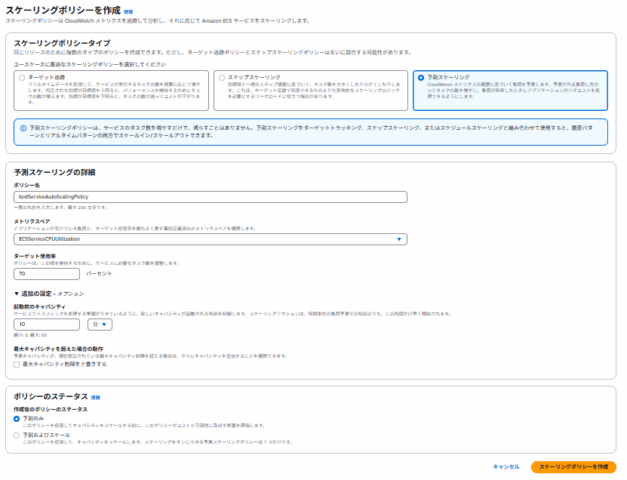
マネージメントコンソールでは、タスク設定後に設定できます。クラスター>クラスタ名>サービスタブ>サービス名>スケーリングポリシータブのスケーリングポリシーで作成します。
Service Auto Scalingの留意点
公式のペストプラクティスをまず確認することをお勧めします。

負荷が低い時の最小のタスク数、スケールアウトした際の最大のタスク数、ピーク状況の想定(時期の規則性、漸進かスパイクといったピーク特性、ボトルネックがCPU/メモリ/セッション数か等)、タスクがReadyになるまでのウォームアップ時間をどの程度許容できるかといったことを元にどの手法を採るか、もしくは併用するかを検討します。
例えば、通常はターゲット追跡を設定しておき、時期により負荷が上がることが予想される場合は、スケジュールスケーリングで、タスクの最低数を上げておくといったことになります。また、負荷の波があり、法則性がある場合は、予測スケーリングを一旦予測のみでモニタリングを設定しておくことも考えます。
なお、組み合わせを行う場合は、需要パターンに基づいたテストシナリオを想定し、実際のコンテナイメージを使用してテストを行うことをお勧めします。
ターゲット追跡
スケールアウトクールダウン時間、スケールインクールダウン時間をタスクの起動とメトリクスへの反映時間を考慮し、スケールアウト/インのアクションの結果がメトリクスに反映される前に次のアクションが起きないようにします。
クラウドでは一般的に高めのしきい値にするが、急激なスパイクがある場合は、スケジュールか予測スケーリングも検討します。
ステップスケーリング
スケールアウトとスケールインは別の設定が必要です。(メトリクスのしきい値が異なるため)
調整対象は、タスクの数か%を指定できるため、ピーク時の想定をしてステップ(メトリクスのしきい値の範囲)と調整対象を検討します。動作は負荷試験等で細かく確認しておいたほうが良いでしょう。
スケジュールスケーリング
指定は最小、最大のタスク数の指定となります。ピーク予測できる場合、タスク数の調整として使用できます。スケールイン、スケールアウトしたい場合は別のスケジュールとして設定します。
予測スケーリング
予測のみと予測とスケーリングどとらかで設定が可能です。一旦予測で設定し、24時間以上予測させてからGUIで予測グラフを確認して、スケーリングさせるかどうかを判断します。
Service Auto Scalingの確認方法
実際の動作を確認するには、ツールやコマンド等で負荷をかけて確認します。簡単に動作を確認したい場合は、abコマンドを使用してもテスト可能です。
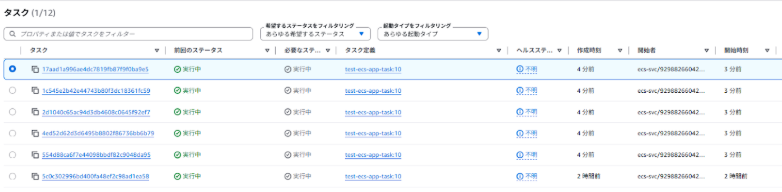
マネージメントコンソールでタスクを確認するには、クラスター>クラスタ名>タスクタブで確認することができます。
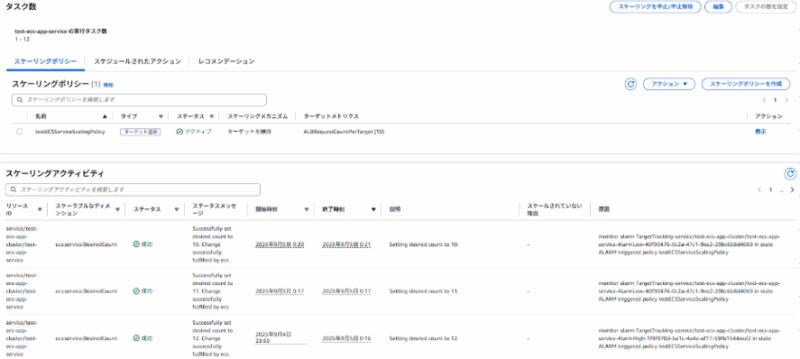
スケールの動作については、クラスター>クラスタ名>サービスタブ>サービス名>サービスの自動スケーリングタブのスケーリングポリシータブにスケーリングアクテビティがあるので、そちらで確認ができます。
メトリクスについては、クラスター>クラスタ名>サービスタブで見るか、CloudWatchから見る場合は、ECSのClusterName,ServiceNameのディメンションで確認します。
コマンドでタスクの一覧を表示するには下記のコマンドを実行します。
$ aws ecs list-tasks --cluster clustername

{
    "taskArns": [
        "arn:aws:ecs:ap-northeast-1:123456789012:task/testECSClusterFargate/2fd9a903f398404fa14dca7121f79426",
        "arn:aws:ecs:ap-northeast-1:123456789012:task/testECSClusterFargate/ae4438f9220249de9773472771b0ae26"
    ]
}
スケーリングアクテビティを確認するには下記のコマンドを実行します。Application-autoscalingのコマンドなので、service-namespaceはecsを指定します。
$ aws application-autoscaling describe-scaling-activities \
  --service-namespace ecs \
  --resource-id service/clustername/servicename

{
    "ScalingActivities": [
        {
            "ActivityId": "d794c300-2553-4680-ab19-57cb8ee25f78",
            "ServiceNamespace": "ecs",
            "ResourceId": "service/clustername/servicename",
            "ScalableDimension": "ecs:service:DesiredCount",
            "Description": "Setting desired count to 14.",
            "Cause": "monitor alarm testECSServiceAlarm in state ALARM triggered policy testECSServiceStepScalingPolicyScaleOut",
            "StartTime": "2025-09-06T13:43:44.251000+00:00",
            "EndTime": "2025-09-06T13:44:16.544000+00:00",
            "StatusCode": "Successful",
            "StatusMessage": "Successfully set desired count to 14. Change successfully fulfilled by ecs."
        },
EKS:Karpenter
EKSのノードのAuto Scalingは主にCluster Autoscalerを使用していましたが、現在はAutoModeを使うとKarpenterによってAuto Scalingが実行されます。
Karpenterの考え方は、AWSのEC2 Auto Scalingと異なり、どのインスタンスタイプで何台にスケールする、ということではなく、許容するインスタンスタイプの中から適宜リソースを準備する、という考え方です。
Karpenterの設定
AutoModeでは特に設定は不要で使用できる状態でクラスターが作成されます。systemおよびgeneral-purposeというノードプールが作成されます。このノードプールは修正してはいけないのですが、カスタマイズしたい場合は、別にノードプールを作成することで、EC2インスタンスカテゴリ、CPU 設定、アベイラビリティーゾーン、アーキテクチャ (ARM64/AMD64)、キャパシティタイプ (スポットまたはオンデマンド)を指定することができます。

なお、自動作成されるノードプールの設定は下記から参照できます。

運用面からノード管理を考えると、AutoModeが有用ですが、AutoModeを使わない場合は、下記のKarpenterの公式ページを参考に導入する必要があります。クラスタを1から導入する設定となっているので、既に導入している場合は、必要な部分を追加する必要があります。(Pod IdentityかIRSA、ノードプールなど)
導入はhelmで行います。
Getting Started with Karpenter
Karpenterの留意点
まず公式のベストプラクティスのページを確認することをお勧めします。
ノード起動時にAZが固まって起動するということはありませんが、1台で済むキャパシティならば分散配置されないため、 DeploymentでtopologySpreadConstraintsのtopologyKey: topology.kubernetes.io/zone、maxSkew: 1とするといったポッド側で対応する必要があります。
Deploymentの指定時にresourcesでrequestsで指定したmemory、cpuによってキャパシティが計算され、足らない場合はスケールされます。requestsが指定されていない場合はlimitsが参照され、両方指定されていない場合は、オーバーコミットされた状態でポッドが起動するため、低負荷時には効率的にポッドが起動できるが、スパイク時にノードの起動が遅れ、ポッドの再配置が起こる可能性があるため、requests、limitsを適切に設定しておく必要があります。
ポッドのオートスケールは後に記載するHorizontal Pod Autoscalerを使用することになるため、実際に使用するイメージを使用し、起動時間や負荷パターンによるスケールが想定通りになるか、試験しておくことが必要となります。スケールアウト、スケールインの待機時間もAutoModeの場合は指定できません。
ノードのAuto Scalingのみの動作を確認するには、ポッド数を増やして動作を確認します。実際の動作を確認するには、後で触れるHorizontal Pod Autoscalerを設定し、ツールやコマンド等で負荷をかけて確認します。
起動当初、systemノードプールは2台のノードとなるが、負荷がないとスケールインされます。また、ポッドが作成されると、general-purposeノードプールのノードが作成され、general-purposeノードプールのノードが2台になると、systemのノードは0台となります。
Karpenterの確認方法
マネージメントコンソールでは、クラスター>クラスタ名>コンピューティングタブで起動しているノード、ノードのインスタンスタイプ、ノードプール名(管理者で判断)が確認できます。

ノード名のリンクをクリックすることにより、そのノードのキャパシティの状況(CPU、メモリ、ポッド数)が確認できます。
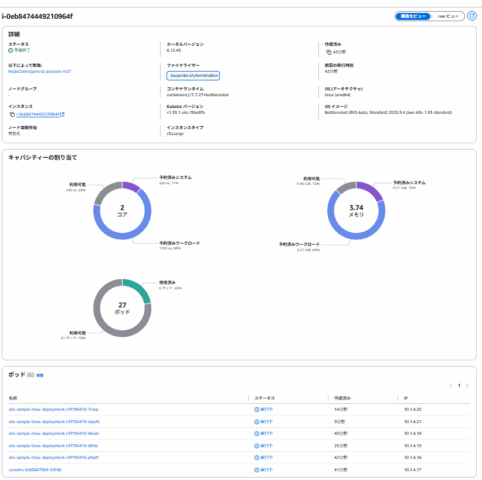
ノードプールと、起動しているノードは下記のコマンドで確認できます。
$ kubectl get nodes -l karpenter.sh/nodepool=system

NAME                  STATUS   ROLES    AGE   VERSION
i-039483da49b1278ca   Ready       38m   v1.33.1-eks-f5be8fb

$ kubectl get nodes -l karpenter.sh/nodepool=general-purpose

NAME                  STATUS   ROLES    AGE    VERSION
i-05b43d76b9ed316f7   Ready       9m4s   v1.33.1-eks-f5be8fb
ポッドがどのノードで実行されているか確認します。
$ kubectl get pod -o wide

NAME                                           READY   STATUS    RESTARTS   AGE   IP          NODE                  NOMINATED NODE   READINESS GATES
eks-sample-linux-deployment-6fc88fd9ff-lwghk   1/1     Running   0          27m   10.1.4.64   i-05b43d76b9ed316f7
ノードの使用状況を確認します。
$ kubectl describe node i-0eb8474449210964f | grep -A 15 "Allocated resources"

Allocated resources:
  (Total limits may be over 100 percent, i.e., overcommitted.)
  Resource           Requests      Limits
  --------           --------      ------
  cpu                1100m (61%)   1 (56%)
  memory             2118Mi (68%)  2218Mi (71%)
  ephemeral-storage  0 (0%)        0 (0%)
  hugepages-1Gi      0 (0%)        0 (0%)
  hugepages-2Mi      0 (0%)        0 (0%)
Events:
  Type     Reason                   Age                  From                   Message
  ----     ------                   ----                 ----                   -------
  Normal   Starting                 30m                  kube-proxy
アドオンのメトリクスサーバーがインストールされている場合は、kubectl topコマンドが使用できます。
$ kubectl top nodes

NAME                  CPU(cores)   CPU(%)   MEMORY(bytes)   MEMORY(%)
i-0481319a4be104efd   23m          1%       392Mi           12%
i-0bd054b19bed2f290   24m          1%       394Mi           12%
EKS:Cluster Autoscaler
AWSらしくAuto Scalingグループを使用する場合は、従来のCluster Autoscalerを使用します。
Cluster Autoscalerの設定
AutoModeではKarpenterが使用され、AutoModeでないのであれば運用上EC2よりもFargateを使用することを考えると、使用機会は減ってくるかと思われます。
下記のGitHubのREADME.mdを参考に導入します。

Cluster Autoscalerの留意点
まず公式のベストプラクティスのページを確認することをお勧めします。

ポッドがスケジューリングできない場合にスケールアウトしますが、デフォルトのスキャン間隔は10秒となります。
その他、多くのパラメータがありますが、デフォルトのパラメータは下記に記載があります。

また上記以外にも多くのパラメータがあり、細かい制御をしたい場合は、設定を検討します。他の方式でも同様ですが、パラメータを調整することにより、期待する動作をしてくれるか、試験を行う必要がありますが、ノード側の制御よりも、Vertical Pod Autoscalerでポッド側の制御をしたほうが良いが場合が多いと思われます。
What are the parameters to CA?
これから導入する場合には、サンプルのファイルが下記にあります。
autoscaler/cluster-autoscaler/cloudprovider/aws/examples
既に導入済みで、現在のパラメータを確認するには、下記のコマンドを実行します。
$ kubectl get deployment cluster-autoscaler -n kube-system -o yamlCluster Autoscalerの確認方法
ノードは、作成当初はAuto Scalingグループで最小数または必要な台数で起動します。Auto Scalingのみの動作を確認するには、サービスで、必要なタスク数を増やして動作を確認します。実際の動作を確認するには、後で触れるHorizontal Pod Autoscalerを設定し、ツールやコマンド等で負荷をかけて確認します。
マネージメントコンソールでは、クラスター>クラスタ名>コンピューティングタブで現在起動しているノードが確認できます。また、ノードグループに希望のサイズが表示されます。

ノードグループ名を開くと、スケーリング設定も確認できます。ノード名を開くと、使用可能なCPU、メモリ、ポッド台数が確認できます。

また、現在起動しているポッドも確認できます。cluster-autoscaler-から始まるポッドは最初のノードだけに配置されます。
Auto Scalingの動作は、Auto Scalingグループのアクテビティ履歴で確認できます。

ノードプールと、起動しているノードは下記のコマンドで確認できます。
$ kubectl get nodes

NAME                                           STATUS   ROLES    AGE     VERSION
ip-10-1-4-63.ap-northeast-1.compute.internal   Ready       7h22m   v1.33.4-eks-99d6cc0
ポッドがどのノードで実行されているか確認します。
$ kubectl get pods -o wide

NAME                           READY   STATUS    RESTARTS   AGE   IP           NODE                                           NOMINATED NODE   READINESS GATES
test-scaling-d9d488755-nwv7j   1/1     Running   0          25m   10.1.4.107   ip-10-1-4-63.ap-northeast-1.compute.internal
test-scaling-d9d488755-pm4t5   1/1     Running   0          13s   10.1.5.25    ip-10-1-5-83.ap-northeast-1.compute.internal
test-scaling-d9d488755-sfzcd   0/1     Pending   0          13s
test-scaling-d9d488755-wp5fv   1/1     Running   0          22m   10.1.5.241   ip-10-1-5-83.ap-northeast-1.compute.internal
上記でPendingのポッドが発生し、ノードがスケールします。
$ kubectl get nodes

NAME                                           STATUS   ROLES    AGE     VERSION
ip-10-1-4-63.ap-northeast-1.compute.internal   Ready       7h53m   v1.33.4-eks-99d6cc0
ip-10-1-5-57.ap-northeast-1.compute.internal   Ready       2m12s   v1.33.4-eks-99d6cc0
ip-10-1-5-83.ap-northeast-1.compute.internal   Ready       25m     v1.33.4-eks-99d6cc0
ノードのResourceの状況を確認します。
$ kubectl describe nodes | grep -A 10 "Allocated resources"

Allocated resources:
  (Total limits may be over 100 percent, i.e., overcommitted.)
  Resource           Requests     Limits
  --------           --------     ------
  cpu                700m (74%)   450m (47%)
  memory             896Mi (62%)  1352Mi (93%)
  ephemeral-storage  0 (0%)       0 (0%)
  hugepages-1Gi      0 (0%)       0 (0%)
  hugepages-2Mi      0 (0%)       0 (0%)
Events:

--
Allocated resources:
  (Total limits may be over 100 percent, i.e., overcommitted.)
  Resource           Requests     Limits
  --------           --------     ------
  cpu                400m (42%)   250m (26%)
  memory             500Mi (34%)  500Mi (34%)
  ephemeral-storage  0 (0%)       0 (0%)
  hugepages-1Gi      0 (0%)       0 (0%)
  hugepages-2Mi      0 (0%)       0 (0%)
Events:
  Type    Reason                   Age                From                   Message
--
Allocated resources:
  (Total limits may be over 100 percent, i.e., overcommitted.)
  Resource           Requests      Limits
  --------           --------      ------
  cpu                650m (69%)    500m (53%)
  memory             1000Mi (69%)  1000Mi (69%)
  ephemeral-storage  0 (0%)        0 (0%)
  hugepages-1Gi      0 (0%)        0 (0%)
  hugepages-2Mi      0 (0%)        0 (0%)
Events:
EKS:Horizontal Pod Autoscaler
ポッドレベルのAuto ScalingはHorizontal Pod Autoscalerを使用します。後で触れるVertical Pod AutoscalerもポッドレベルのAuto Scalingに使用しますが、スケールアップする仕組みとなり、コンテナ環境のスケールは、負荷状況によってポッド数を増減させるスケールアウト/スケールインが望ましく、基本的にはこちらを使用します。
Horizontal Pod AutoscalerはポッドのCPU使用率等のメトリクスでポッドの数をスケールします。
Horizontal Pod Autoscalerの設定
Horizontal Pod Autoscalerは、EKSにアドオンとしてメトリクスサーバーを導入するだけで使用できます。
メトリクスサーバーは、クラスター作成時のアドオンの追加(コミュニティアドオン)、もしくは導入後にクラスタのアドオンタブから追加できます。
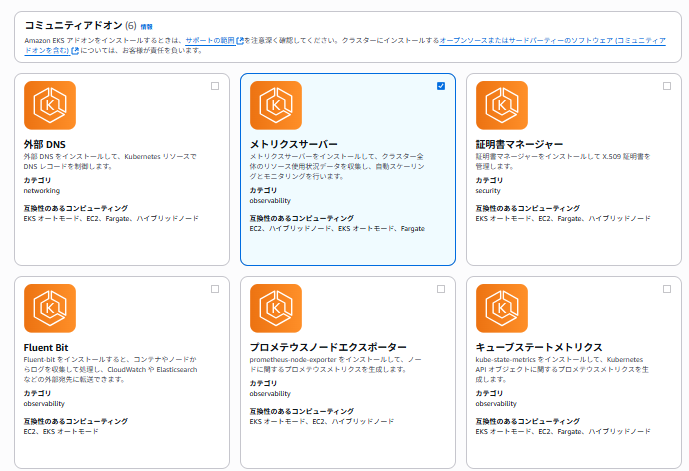

CloudFormationでも下記のようなResource記述で追加することができます。
  MetricsServerAddon:
    Type: AWS::EKS::Addon
    Properties:
      AddonName: metrics-server
      ClusterName: ClusterName
      ResolveConflicts: OVERWRITE
Auto Scalingの設定は、下記コマンドで実行します。下記のようにdeploymentに対して、しきい値(cpu-percent)、最小数、最大数を指定します。
$ kubectl autoscale deployment app-name --cpu-percent=50 --min=1 --max=10

horizontalpodautoscaler.autoscaling/app-name autoscaled
下記のようなマニフェストで設定することも可能です。下記はmetoricsやbehaviorも追加したサンプルとなります。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: app-name-hpa
  namespace: default
  labels:
    app:  app-name
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: app-name
  minReplicas: 2
  maxReplicas: 20
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
  - type: Resource
    resource:
      name: memory
      target:
        type: Utilization
        averageUtilization: 80
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300
      policies:
      - type: Percent
        value: 10
        periodSeconds: 60
    scaleUp:
      stabilizationWindowSeconds: 0
      policies:
      - type: Percent
        value: 100
        periodSeconds: 15
      - type: Pods
        value: 4
        periodSeconds: 15
      selectPolicy: Max
Horizontal Pod Autoscalerの留意点
Horizontal Pod Autoscalerについての詳細は下記を参照します。
Horizontal Pod Autoscalerは、デフォルトでは15秒間隔でCPUの負荷を確認します。
上記間隔でしきい値を上回っている限り、maxのポッド数までスケールします。(負荷は平均値なので、スケールしていくと、減っていくことになります。)
起動に時間がかかるポッドの場合、ポッドの起動がメトリクスに影響しない可能性があり、さらにスケールする可能性があるため、behaviorでscaleUpの待機時間(stabilizationWindowSeconds)を調整する必要があります。
スケールダウンは、5分の待機時間があります。
AutoModeでは、ノードのキャパシティが足らなくなるまで、次のノードが起動されないため、最初の1台の状態では、AZが単数で動作しています。 ポッドがスケールした際に、AZに偏らないためには、DeploymentでtopologySpreadConstraintsのtopologyKey: topology.kubernetes.io/zone、maxSkew: 1とするといった設定が必要となります。
また、複数のDeploymentがある場合は、配置戦略やリソース指定、ポッドの起動時間とノードのスケーリングの兼ね合いで、予期せぬ再配置が発生することがあるため、負荷シナリオを検討し、試験する必要があります。
Horizontal Pod Autoscalerの確認方法
実際の動作を確認するには、ツールやコマンド等で負荷をかけて確認します。簡単に動作を確認したい場合は、abコマンドをしてもテスト可能です。
また、下記でテスト例も記載されているので、参考になるかと思います。
メトリクスサーバーが動作していることの確認は下記コマンドを使用します。
$ kubectl get deployment metrics-server -n kube-system

NAME             READY   UP-TO-DATE   AVAILABLE   AGE
metrics-server   2/2     2            2           2m
負荷状況の確認は下記のコマンドを使用します。
$ kubectl get hpa app-name

NAME         REFERENCE               TARGETS        MINPODS   MAXPODS   REPLICAS   AGE
app-name   Deployment/app-name   cpu: 46%/50%   1         10        6          66m
起動しているpodの確認は下記コマンドを実行します。
$ kubectl get pod

NAME                          READY   STATUS    RESTARTS   AGE
app-name-6487c65df8-4gxkq   1/1     Running   0          96s
app-name-6487c65df8-bvtsf   1/1     Running   0          96s
app-name-6487c65df8-jhs4x   1/1     Running   0          70m
app-name-6487c65df8-k2xqz   1/1     Running   0          81s
app-name-6487c65df8-xcjqq   1/1     Running   0          96s
app-name-6487c65df8-z6fnl   1/1     Running   0          66s
EKS:Vertical Pod Autoscaler
ポッドレベルのAuto Scalingの手法として、スケールアップを行うVertical Pod Autoscalerについても簡単に触れておきます。
コンテナ環境なので、負荷状況によってポッド数を増減させるスケールアウト/スケールインが望ましく、基本的にはHorizontal Pod Autoscalerを使用しますが、スケールアップ/ダウンで対応するケースで使用します。
Vertical Pod Autoscalerの設定
こちらもメトリクスサーバーを使用します。下記リンクを参考にアドオンを追加します。
Vertical Pod Autoscalerのインストールは下記リンクを参考にします。

下記のサンプルのように、kind: VerticalPodAutoscalerのspecの指定で、対象のDeploymentを指定しますresourcePolicyで最小、最大値を指定します。
apiVersion: "autoscaling.k8s.io/v1"
kind: VerticalPodAutoscaler
metadata:
  name: app-name-vpa
spec:
  targetRef:
    apiVersion: "apps/v1"
    kind: Deployment
    name: app-name  # Deploymentの名前を指定
  updatePolicy:
    updateMode: "Auto"
    minReplicas: 3
    evictionRequirements:
    - resources: ["cpu", "memory"]
      changeRequirement: "TargetHigherThanRequests"
  resourcePolicy:
    containerPolicies:
    - containerName: app
      minAllowed:
        cpu: 200m
        memory: 256Mi
      maxAllowed:
        cpu: 4000m
        memory: 8Gi
      controlledResources: ["cpu", "memory"]
Vertical Pod Autoscalerの留意点
アドオンのメトリクスサーバーが必要な他、vpa-admission-controller、vpa-recommender、vpa-updaterといったポッドが動作するのでオーバーヘッドがあります。
スケールする場合は、ポッドの再起動を伴います。
updateModeがAutoだと、10%変動でスケールアップ、スケールダウンがトリガーされてしまうので、Offで分析する、Initialで新しいポッドのみ適用する、など確認が必要です。
再起動でサービスが中断しないように、minReplicasで最低限維持するポッド数を指定します。
changeRequirementの指定(下記)や、minAllowed、maxAllowedの値で動作を確認します。
spec:
  updatePolicy:
    updateMode: "Auto"
    evictionRequirements:
    # 1. 推奨値が現在の要求値より高い場合のみ再起動
    - resources: ["cpu", "memory"]
      changeRequirement: "TargetHigherThanRequests"

    # 2. 推奨値が現在の要求値より低い場合のみ再起動
    - resources: ["cpu", "memory"]
      changeRequirement: "TargetLowerThanRequests"

    # 3. 推奨値が現在の制限値より高い場合のみ再起動
    - resources: ["cpu", "memory"]
      changeRequirement: "TargetHigherThanLimits"
関連記事
-
 ECS/EKSのIPアドレス設計
-
 ECS/EKSでのIAM使用
-
 CursorでECS/EKSのMCP Serverを使う