
動いている本番AWS環境のコストを棚卸ししてみた 〜CDKコード×実測の2段構え〜
目次
本記事では、実運用中の AWS 本番環境(AWS CDK で IaC 管理)のコストを棚卸しした過程を紹介します。IaC コードと、CloudWatch / Cost Explorer による実測の両面から、セキュリティを落とさずに削減余地を洗い出しました。Aurora Serverless v2 のサイジング、ECS Fargate の適正化、「棚卸しで必ず出てくる置き忘れ」まで、実際の数字と、途中での早合点や勘違いも交えます。
この記事の要約
- 動いている本番は止めにくいぶん、コストに手を入れるのが怖い。だから「IaC コードで当たりをつけて、実測で裏取りする」2段構えで安全に踏み込んだ
- いちばんの学びは 「平均は嘘をつく」。クラスタ平均だけ見て「このリードレプリカはアイドルだ、消せば半額だ」と早とちりしかけたが、インスタンス単位+ピーク値で見たら逆だった
- Aurora Serverless v2 は 設定上の最大 ACU ではなく実消費 ACU で課金される。
maxCapacity: 8を見て「過大だ」と勢い込むと外す - コードと実測、どちらか片方だけだと足りない。両方を突き合わせて初めて、IaC 管理外の野良リソースや、コードにない幽霊リソースが見える
1. なぜ「動いている本番」のコスト最適化は難しいのか
コスト削減の記事は世にあふれていますが、その多くは「未使用の EBS を消そう」「S3 のライフサイクルを設定しよう」といった一般論です。いざ自分の動いている本番環境に向き合うと、そう簡単ではありません。
- 止められない。サービスが動いているので「とりあえず消して様子を見る」ができない
- 触るのが怖い。サイズを下げて障害が出たら本末転倒
つまり本番のコスト最適化は、「どこに無駄があるか」を正確に当てて、「下げても安全か」を裏取りする作業です。勘でリソースを削るのは一番やってはいけないことです。
2. アプローチ: コードで当たり → 実測で裏取りの2段構え
そこで今回は、次の2段構えで進めました。
- IaC コード(CDK)を読んで当たりをつける。どんなリソースが、どんなサイズで定義されているかを把握し、「大きそうな箇所」の仮説を立てる
- 実環境を read-only で計測して裏取りする。Cost Explorer で実際の費用を把握する。CloudWatch で実際の使用率を確認し、仮説が正しいか検証する
ポイントは、コードと実測のどちらか一方では足りないということです。コードは「設定値(想定)」しか教えてくれず、実測は「結果」しか教えてくれません。両方を突き合わせて初めて、「想定はデカいのに実際はガラガラ」という乖離が見えます。
なお調査はすべて read-only(describe / list / get 系)で行い、本番には一切変更を加えていません。実際の削減適用はチーム側で別途行い、削減額は後日談として追記する予定です。
3. やってみた
対象は、ごく標準的な構成の Web アプリ基盤です。フロントエンドは ECS Fargate + ALB + CloudFront。バックエンドは Aurora と DynamoDB。Aurora は MySQL と PostgreSQL の2系統で、いずれも Serverless v2 です。検証環境と本番環境は、それぞれ別の AWS アカウントに分かれています。
3-1. まず、いちばんデカいところを測る
コスト最適化の鉄則は「金額の大きいところから」です。Cost Explorer でサービス別に分解したところ、本番では RDS(Aurora)だけで総コストの約 44% を占めていました。
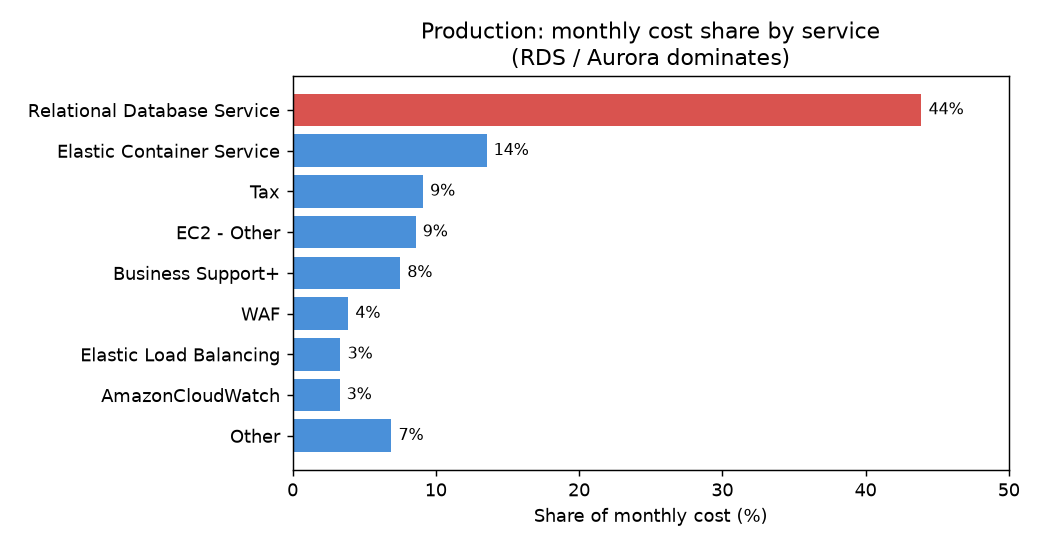
迷わず Aurora から攻めます。
3-2. Aurora を疑う → そして勇み足
CDK のコードを開くと、Aurora Serverless v2 の容量設定はこうなっていました(抜粋・一部改変)。
const cluster = new rds.DatabaseCluster(this, "AuroraCluster", {
  engine: rds.DatabaseClusterEngine.auroraMysql({ version }),
  serverlessV2MinCapacity: 0.5,
  serverlessV2MaxCapacity: 8, // ← これ、デカすぎでは?
  writer: rds.ClusterInstance.serverlessV2("writer"),
  readers: [rds.ClusterInstance.serverlessV2("reader")],
});
serverlessV2MaxCapacity: 8。8 ACU といえばそれなりの規模です。「利用想定が大きすぎたんだな、これを 2 とかに下げれば一気に安くなるぞ」と、このときの私は思っていました。
ところが、これが最初の早合点でした。
Aurora Serverless v2 の課金は、設定した最大 ACU ではなく、実際に消費した ACU(ACU 秒)に対してかかります。maxCapacity はあくまで「上限」であって、そこに張り付かない限り請求には効きません。実消費が常時 1 ACU 程度なら、上限を大きくしても請求はほとんど変わりません。
補足: もちろん上限を下げること自体に意味(暴走時のコスト青天井を防ぐガードレール)はあります。ただし**「上限を下げる=節約」ではない**。本当の請求ドライバは、最小 ACU(床)× インスタンス数です。
つまり見るべきは「設定の最大値」ではなく「実際にどれだけ消費しているか」。CloudWatch を見にいきます。
3-3. 「平均は嘘をつく」— リードレプリカを消しかけた話
本番の MySQL クラスタは writer + reader の2インスタンス構成です。まずクラスタ全体をざっと見ると、DB 接続数の平均はほぼ 0、ACU も最大 8 に対してずっと低いまま。数字の上では、ほとんど使われていないように見えました。
「なるほど、ほぼアイドルだ。しかも reader まで立っている。reader を外せばベースラインが半分になるじゃないか」— これが2回目の勘違いでした。
念のため、と思って インスタンス単位+最大値+時間帯で見直したところ、絵がひっくり返りました。
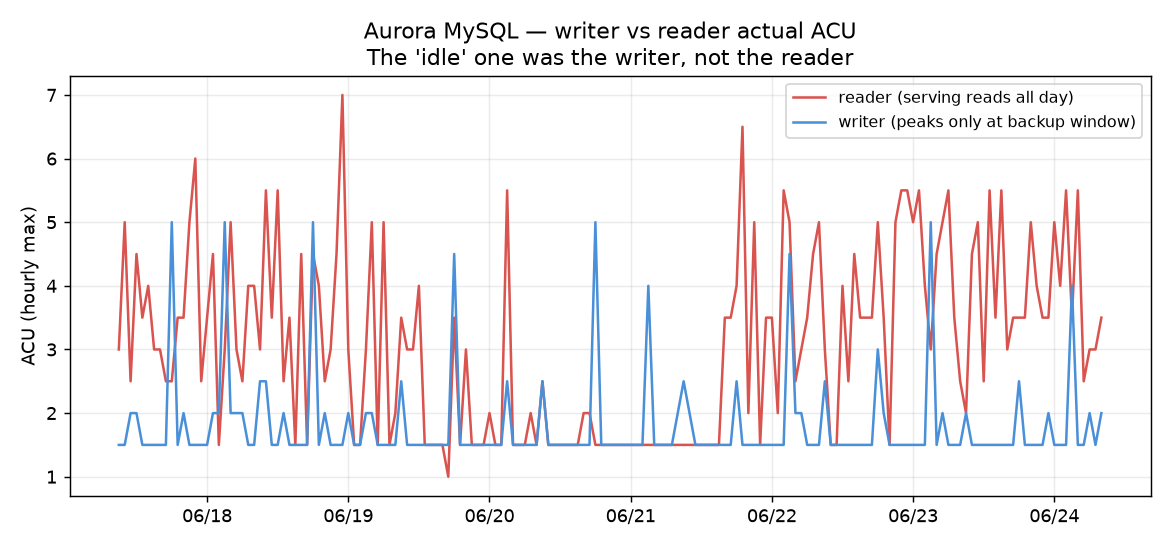
| インスタンス | CPU 平均 / 最大 | ACU ピークの出方 |
|---|---|---|
| writer | 6% / 27% | JST 03:00・12:00 に集中(=バックアップ窓と一致) |
| reader | 6% / 61% | 日中、不規則に多数スパイク |
実態はこうでした。
- reader こそ実働していた。CPU は瞬間的に 61% まで上がる。日中は不規則にスパイクしながら読み取りを捌いている(ストレージ I/O が 0 なのは、結果がバッファキャッシュに乗っているためとみられる)
- アイドルだったのは writer のほう。CPU のピークはバックアップ窓の時刻ときれいに一致していて、ユーザー由来の負荷はほとんどない
もし平均値だけを信じて reader を削除していたら、日中の読み取り負荷がぜんぶ writer に乗って、本番が詰まっていた恐れがあります。クラスタ平均や接続数の平均だけで「アイドル」と断じるのは危険です。Average 統計は、短時間のスパイクを平らに均してしまうからです。
そこで reader は残します。ただし maxCapacity: 8 は実ピーク(6〜7 ACU)に対して余裕がありすぎます。上限は 7 程度に寄せておきます。3-2 で見たとおり、課金そのものは変わりません。暴走時のガードレールとして健全になります。
ここでの教訓は、次の3点です。
- インスタンス単位で見る(writer と reader は別物)
AverageだけでなくMaximumを見る(ピークは平均に埋もれる)- ピークが出る時刻を見る(バックアップ窓なのか、日中の業務時間なのか)
地味ですが、これが「下げても安全か」を見極めるための必須手順です。
ちなみに、本当にアイドルだったクラスタは別にいました。同じ Aurora でも、PostgreSQL の2クラスタは接続数・ACU とも終始ほぼ床に張り付いたまま。日中スパイクする mysql の reader と違い、こちらは正真正銘ほとんど使われていません。サイジングを見直すなら、まずこういう「本当に空いている」ところが本命です。
3-4. ECS も測る — こちらは本当にガラガラだった
DB の次は compute です。本番の ECS サービスは、1 vCPU / 2 GB のタスクを 2 つ動かしていました。CloudWatch で使用率を確認すると、次の値でした。
- CPU 使用率: 平均 0.05% / 最大 1%
- メモリ使用率: 平均 1.7% / 最大 1.9%
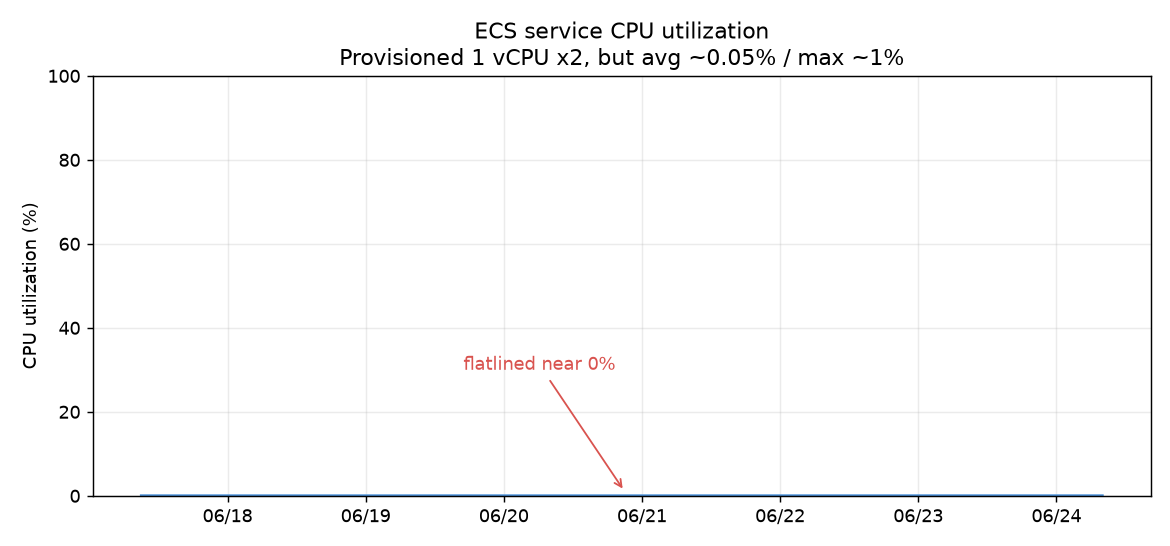
桁を間違えていないか何度か見直しました笑。0.05%。Aurora の reader と違い、ECS はすっかり持て余していました。
金額の大きさでは Aurora が主役でした。ただ、実働だった Aurora の reader は削りしろが限られます。使用率 0.05% の ECS は、削りしろがそっくり残っていました。金額の順位と「削れる順位」は、必ずしも一致しません。
オートスケールも設定されていました(最小2・最大3、CPU/メモリ 70% 目標)。ただし、この負荷では一生発火しません。つまり台数の問題ではなく、タスクサイズが過大ということ。
ここでも1つ注意。「じゃあ 0.25 vCPU / 0.5 GB まで一気に下げよう」と言いたくなりますが、メモリは使用率が低くてもアプリの常駐分やコンテナイメージ次第で OOM のリスクがあります。いきなり最小にせず、実 RSS を確認して 0.5 vCPU / 1 GB あたりから段階的に下げるのが安全です。
3-5. 棚卸しで必ず出てくる「置き忘れ」
ここからは、コード調査と実測の合わせ技でしか見つからない「置き忘れ(幽霊リソース)」です。
幽霊その1: コードにないのに本番に居た Aurora クラスタ
Cost Explorer と実リソースを突き合わせると、CDK のコードには存在しないのに、本番に インスタンス数ゼロの Aurora クラスタが1つ居ました。過去の検証で作られて、消し忘れられたものです。インスタンスが無いので compute 課金はありませんが、ストレージは残り続けます。これはコードを読むだけでは絶対に気づけません(コードには無いので)。
幽霊その2: 一度も使われていないログ分析基盤
Athena + Glue + Firehose で立派なログ分析基盤が構築されていましたが、クエリ実行履歴を見ると 実行回数 0。「作ったはいいが使われていない」よくあるパターンです。
セキュリティとコストが同時に効くケース: 置き忘れの WAF
WAF を見ると、検証用に作ったとおぼしきテスト用 Web ACL が、本番アカウントにも残っていました。WAF の Web ACL は存在するだけで固定費がかかります。おまけに、検証環境の WAF 費用が本番より高いという逆転まで起きていました。犯人は、この置き忘れ ACL です。使われていない ACL はコストであると同時に、棚卸しされていないアタックサーフェスでもあります。消せば、固定費が減り、かつ管理対象がきれいになる — コストとセキュリティが同じ方向を向く、気持ちのいいケースです。
3-6. 想定が外れたところ: DR は「高そう」で止まっていた
事前の心配のひとつに「DR 環境が中途半端なまま、費用だけ食っているのでは」というものがありました。セカンダリリージョンにバックアップ系のリソースがあるのは把握していたからです。
ところがリージョン別にコストを分解すると、セカンダリリージョンの月額はほぼ誤差。削減インパクトという観点では、ここに時間をかける価値はありませんでした。「高そう」という印象だけで作業に入らなくてよかった、という話です。コスト最適化は感覚ではなく金額の大きい順に、を改めて。
4. 安全に削るための原則
今回の棚卸しで効いた原則をまとめます。
- 金額の大きいところから測る。請求の支配項(今回は Aurora)から手をつける。「高そう」という印象では動かない
- 設定値ではなく実測値を見る。
maxCapacity: 8のような上限値に惑わされない。Serverless v2 は実消費課金。本当のドライバは min(床)× インスタンス数 - 平均ではなくピークと時間帯を見る。インスタンス単位で、
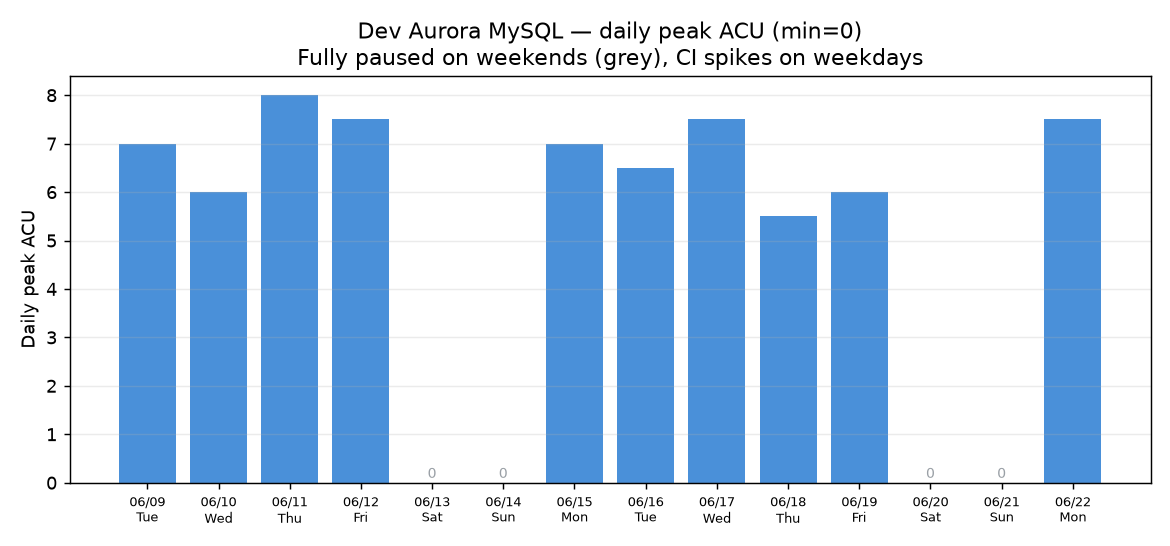
Maximumで、いつ上がるかで。平均は実態を平らに均してしまう - 検証環境と本番で扱いを変える。たとえば最小 ACU を 0 にする(scale-to-zero)のは、再開レイテンシを許容できる検証環境では有効でも、本番ではユーザー影響が出うる。実際、今回の検証環境の DB は週末に完全停止(最小0)し、平日だけ CI で跳ねる、という理想的な動きをしていました
補足として、環境ごとに AWS アカウントを分けていたのが効きました。アカウント別コストがそのまま環境別コストになり、タグ按分で悩む必要がありません。コスト最適化の地味な前提条件として、アカウント分離は効きます。
5. これから行う削減アクション(予定)
棚卸しの結果から、次の修正を順に進めていきます。どれも read-only の調査で裏取りしました。適用はチームの変更フローに沿って行います。
| 修正箇所 | 対応 | ねらい | リスク・前提 |
|---|---|---|---|
| ECS タスク定義(cpu / memory) | 1 vCPU / 2 GB → 0.5 vCPU / 1 GB を起点に段階縮小 | 使用率 0.05% に対し過剰なぶんを回収 | 実 RSS を確認し段階適用 |
| Aurora PostgreSQL クラスタ | 真のアイドル。reader の要否と最小 ACU を見直し | ベースライン(床 × 台数)を圧縮 | 読み取り経路の確認 |
Aurora MySQL の maxCapacity | 8 → 実ピークの 7 程度へ | 課金は不変・ガードレールの健全化 | コスト目的ではない |
| 幽霊 Aurora クラスタ | 削除 | ストレージ課金とアタックサーフェスを除去 | データ要否の最終確認 |
| 未使用ログ分析基盤(Firehose / Glue / Athena) | 要否を判断のうえ撤去 | 維持コストと運用の複雑さを削減 | 将来必要になれば再構築 |
| 置き忘れ test WAF ACL | 削除 | 固定費の削減+運用の衛生向上 | 参照中でないかの確認 |
| 夜間・休日の自動停止(EventBridge Scheduler) | 検証環境は導入済み。停止対象の拡張を検討 | 非稼働時間ぶんの課金を削減 | 本番は対象外 |
金額の効果は、適用後の Cost Explorer で実測して後日談にまとめます。
さいごに
「動いている本番は触りにくい」を、コード×実測の2段構えで1つずつ崩していきました。洗い出した削減候補は、ECS タスクの適正化、アイドルな PostgreSQL クラスタの見直し、幽霊クラスタ・未使用ログ基盤・置き忘れ WAF の撤去など。一方で、「reader を消す」「DR を削る」は裏取りした結果あえて見送りました。これも棚卸しの成果です。
何より、途中の思い込みを実測が何度も救ってくれました。これが今回いちばんの学びです。コスト最適化は、勘ではなく数字で判断する。その数字も、平均ではなくピークと時間帯で見る。
実際の削減を適用したあとの before / after は、後日談として追記します。
この検証は、弊社が運用している AWS 基盤の運用知見の一環として行ったものです。
